
>
>
公開日
最終更新日
Amazon Bedrockは、社内チャット、文書検索、帳票処理、開発支援、AIエージェントなどをAWS環境で実装したい情報システム部門向けの生成AI基盤です。個人が完成済みのチャット画面を使うサービスではなく、複数の基盤モデルをAPIで呼び出し、自社の認証、ネットワーク、ログ、費用管理へ組み込む用途に適しています。
IPAが公開した「情報処理技術者試験 中核人材育成プログラム 最終報告書」(2024年)は、「企業IT利活用動向調査 2024」の結果として、回答企業の69.5%が生成AIを導入済みまたは導入予定と回答したと紹介しています。数値の定義や母集団の詳細は同報告書でご確認ください。一方で、業務データを扱う生成AIでは、モデル性能だけでは導入判断を完結できません。入力可能な情報、処理リージョン、権限、出力の承認、トークン費用を設計しなければ、便利なPoCが監査できない本番システムになりかねません。
ここではAmazon Bedrockとは何かを最初に整理し、料金体系と月額試算の考え方、Grok 4.6を含むモデル選定、AWS Bedrockを安全に運用するための実務部品までを扱います。
Amazon Bedrockとは
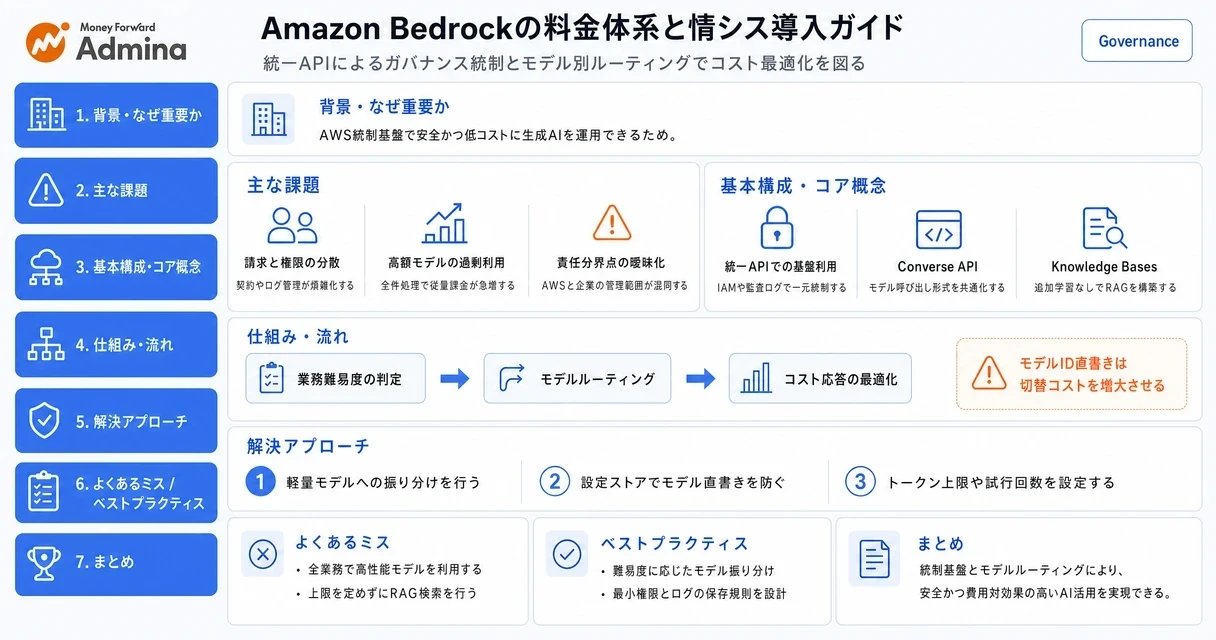
Amazon Bedrockは、複数社の基盤モデルを同一のAWSセキュリティ境界内で安全に運用するためのAPI基盤です。
本記事のポイント
情シスが導入判断で先に押さえるべき結論は次のとおりです。なお、本記事ではモデルの具体的な単価やGrok 4.6の提供可否を断定しません。単価はAWS公式料金表(aws.amazon.com/jp/bedrock/pricing/)をリージョン・モデルIDを指定して参照し、Grok 4.6の提供状況はAWSコンソールの「モデルアクセス」画面で確認します。確認できればその値で試算し、確認できなければ別モデルをPoC対象にします。
Amazon Bedrockは完成済みのAIチャットではなく、生成AIアプリケーションを開発・運用するためのAWSサービスです。
モデル提供会社ごとにAPIキーや請求を分散させず、IAM、CloudTrail、AWS Billingを軸に統制できます。
料金は月額固定ではなく、モデル別の入力・出力トークン、RAG、ログ、データ保存などを合算して判断します。
高性能モデルを全件に使うのではなく、軽量モデルとのルーティングで品質と費用を両立させます。
サービスの定義と役割
Amazon Bedrockとは、AWSが提供するフルマネージド型の生成AIサービスです。経済産業省は、Amazon Bedrockを複数のAI企業およびAmazonの基盤モデルを統一APIで提供するサービスとして紹介しています。利用企業はGPUサーバーや大規模言語モデルの実行基盤を自前で保守せず、アプリケーションからAPIを呼び出して文章生成、要約、検索拡張生成、画像処理、エージェント処理を実装します。
代表的な基盤モデルには、Amazon Nova、Anthropic Claude、Meta Llama、Cohere、Mistral AIなどがあります。IPAは、「情報処理技術者試験 中核人材育成プログラム 最終報告書」(2024年)において、2024年6月時点の代表的な大規模言語モデルとして、Claude 3、Gemini、Llama 3、GPT-4を挙げています。モデルの提供状況、利用可能なリージョン、入力形式、ツール利用の可否はモデルごとに異なるため、Bedrockを導入しても全モデルを同じ条件で使えるわけではありません。
情シスにとっての位置付けは、「社内の生成AI利用を一つの製品に統一すること」ではなく、「複数のモデルを使うアプリケーションを、AWSの権限・ネットワーク・監査・請求管理の中へ収めること」です。すでにAWSアカウント、IAMロール、VPC、KMS、CloudTrailを運用している企業では、既存の統制方式を生成AIにも広げやすくなります。
Amazon BedrockとChatGPTの違い
Amazon Bedrockは自社システムにAI機能を組み込む開発・統制プラットフォームであり、ChatGPTなどの企業向けAI SaaSは従業員がそのまま使える完成型サービスです。
比較軸 | Amazon Bedrock | ChatGPTなどの企業向けAI SaaS |
|---|---|---|
主な利用者 | 開発部門、情シス、業務システム担当者 | 一般従業員、個人業務の利用者 |
主な用途 | 自社チャット、RAG、帳票処理、社内API連携 | 文章作成、要約、壁打ち、ファイル分析 |
画面 | 自社でWeb画面や業務画面を実装します | 提供会社の完成済み画面を利用します |
モデル | 複数の対応モデルを用途ごとに選択します | 提供会社が指定するモデルが中心です |
認証・監査 | IAM、CloudTrail、AWSアカウント設計と統合します | 各SaaSの管理コンソールと監査機能を利用します |
費用の単位 | トークン、リクエスト、周辺AWSサービスの従量課金が中心です | ユーザー単位の月額課金が中心です |
従業員がすぐに対話型AIを使うことだけを目的にする場合は、完成型SaaSのほうが画面開発や運用設計を抑えられます。反対に、問い合わせシステム、契約書管理、営業支援、障害調査などへAIを埋め込み、利用者やデータの権限を既存システムに連動させるならAmazon Bedrockが候補になります。
個人契約のAIサービスへ業務情報が入力されるシャドーAIも、情シスの管理対象です。承認済みの生成AI環境を用意するだけでなく、シャドーAI管理機能で未承認利用を把握する運用を組み合わせます。シャドーAIとは?情報漏洩リスクと情シス向け検知・対策ガイドでは、検知対象と社内ルールの整備方法を解説しています。
企業導入が進む背景
生成AIの検討は実験段階を超え、統制を前提にした業務利用へ移っています。イマジン出版は、矢野経済研究所の2025年調査(496社対象)として、生成AIを全社的に活用している企業は11.3%、一部の部署で活用している企業は32.1%であり、合計43.4%が利用を開始していると紹介しています。
同調査では、生成AIを活用している215社のうち、AIエージェントを利用中の企業は3.3%、導入検討中は13.5%、関心を持ち情報収集している企業は49.3%でした。エージェントは今後の利用拡大が見込まれる一方、外部ツールを呼び出してデータを更新するため、通常のチャットよりも権限、監査、人の承認を細かく設計する必要があります。
▶ 関連記事: シャドーAIとは?情報漏洩リスクと情シス向け検知・対策ガイド
企業利用を支えるAmazon Bedrockの主な機能
Bedrockは単なるモデル呼び出しだけでなく、RAG・エージェント・ガバナンス機能を共通基盤として提供します。
モデル切替を支えるConverse API
Converse APIは、対応モデルに対して共通的な会話形式でリクエストを送るためのAPIです。アプリケーション側はメッセージ、システム指示、ツール利用、応答形式をできるだけ共通化し、モデル固有の差分をアダプター層へ閉じ込めます。
ただし、Converse APIを使っても、すべてのパラメーターや機能が完全に共通化されるわけではありません。画像入力、思考・推論設定、キャッシュ、停止理由、構造化出力、ツール利用の細部はモデルごとに差があります。モデルID、最大出力、温度、ガードレールIDを業務ロジックへ直書きすると切替コストが増えるため、設定ストアとモデル固有アダプターへ分離します。
社内検索を実装するKnowledge Bases
Knowledge Bases for Amazon Bedrockは、社内文書を検索して関連情報をプロンプトへ渡すRAGを構築する機能です。規程、製品資料、FAQ、技術文書などをモデルへ追加学習させず、回答時に参照させるため、文書更新を回答へ反映しやすくなります。
RAGの精度はモデル名だけで決まりません。文書をどの長さで分割するか、タイトル・部署・版数・機密区分などのメタデータを付与しているか、検索結果を何件渡すかで回答品質と費用が変わります。人事規程と全社FAQを同一の検索対象に無条件で格納すると、権限のない利用者に検索結果が返る設計になります。閲覧権限を検索前のフィルターへ反映できるなら限定PoCへ進み、反映できないなら公開済み文書だけを対象にします。
回答画面には、文書名、版、更新日、引用箇所を表示します。根拠が表示されない回答は、正しい内容に見えても利用者が検証できません。RAGの構成要素と導入判断については、【2026年最新】RAGとは?仕組み・最新動向と情シス導入手順も参照できます。
自律実行を担うAgentCoreとBedrock Agents
Bedrock Agentsは、利用者の依頼に応じてナレッジベース検索や業務API呼び出しを組み合わせるエージェント機能です。AgentCoreは、エージェントの実行、ID、メモリ、ツール接続、監視を扱うための基盤です。
AgentCore Identityでは、エージェント用IDを発行・管理できるとされています。なお、Agentic AIの統制領域については、ID管理、データ・メモリ・状態の保護、監査・ログ、エージェントと基盤モデルの制御、権限境界とポリシー、オーケストレーションといった複数の観点から整理する議論があります。具体的な領域の定義や範囲は資料や文脈によって異なるため、AWSの公式ドキュメントおよび各社のガバナンス方針を参照して自社の統制設計に適用します。
エージェントのPoCでは、「回答できたか」だけで合否を決めません。代表タスク100件程度を用意し、完了率、誤操作件数、平均ツール呼び出し回数、95パーセンタイル応答時間、1件当たりの費用、担当者への引継ぎ率を記録します。参照専用の操作で完了率と根拠表示を評価し、更新操作は別の検証項目として扱うと、便利なデモと安全な本番設計を混同せずに済みます。
非構造化データを処理するBedrock Data Automation
Bedrock Data Automationは、PDF、画像、音声、動画などの非構造化データから、業務で使う項目を取り出す用途に適した機能です。請求書、申込書、点検票、契約書、通話記録を後続の検索やワークフローへ渡す前に、必要な形式へ整理できます。
導入時は、帳票全体の正解率だけではなく、必須項目ごとの見逃しを分けて測定します。たとえば請求書の取引先名、請求金額、支払期日、振込先のうち、振込先だけは誤認識を許容できない場合があります。正常な帳票だけでなく、手書き、低解像度、傾き、複数ページ、項目欠損を含む評価データを用意し、抽出結果を人が原本と照合する工程を残します。
入出力を統制するBedrock Guardrails
Bedrock Guardrailsは、有害なコンテンツ、禁止トピック、カスタム単語、個人情報、根拠性に関するルールを、アプリケーション側で設定するための機能です。AWSの公式解説では、カスタム単語フィルターへ最大10,000項目を追加できます。社名、サービス名、社外秘のプロジェクトコード、禁止用語などを登録し、業務ごとに異なる制御を適用できます。
Guardrailsは情報漏えい対策の代替ではありません。入力前のデータ分類、IAMによる実行権限、RAG検索対象のアクセス制御、出力後の人による承認を重ねて初めて業務利用へ近づきます。個人情報や秘匿情報を扱うなら、Guardrailsのブロック結果と利用者への案内文をあらかじめテストし、必要な問い合わせまで止めないかを測定します。
▶ 関連記事: 【2026年最新】RAGとは?仕組み・最新動向と情シス導入手順
Grok 4.6対応の意味とxAI直APIの違い
Grok 4.6のAmazon Bedrock経由での提供状況は、本記事作成時点の一次情報では確認できていません。そのため本節では、xAIモデルをBedrock経由で利用する場合に一般的に得られる統制上の利点と、xAI直APIとの比較軸を整理します。提供の有無・リージョン・料金はAWSコンソールの「モデルアクセス」画面と公式料金表(aws.amazon.com/jp/bedrock/pricing/)で確認し、利用可能と判明した時点で評価対象に加えます。
提供状況の判断基準
Grok 4.6については、モデルID、利用可能リージョン、推論プロファイル、コンテキスト長、推論負荷、トークン単価を、導入時点のAWS公式サービス画面と料金表で個別に記録します。モデルは段階提供されることがあり、Amazon Bedrockそのものを利用できるリージョンと、当該モデルを直接推論できるリージョンは一致しない場合があります。
Grok 4.6のモデルID、コンテキスト長、推論設定などの仕様詳細は、AWSコンソールの「モデルアクセス」画面および公式料金表(aws.amazon.com/jp/bedrock/pricing/)で最新情報を確認し、導入時点の値を記録します。社内データを日本国内で処理する契約条件がある場合は、処理先リージョンを国内へ限定できることが確認できれば本番候補とし、確認できなければ匿名化済みデータのPoCまたは別モデルへ切り替えます。
長いコンテキストを扱えるモデルであっても、毎回すべての文書やコードを投入する設計は採りません。入力トークンが増えるほど料金と応答時間が増え、無関係な情報が混ざることで回答精度も下がります。文書検索やコード検索で対象箇所を絞り、必要な場合だけ高性能モデルへ昇格させる設計が現実的です。
xAI直APIとBedrock経由の比較
xAI直APIはxAIの機能を直接利用する構成であり、Amazon BedrockはAWSの統制機能を経由して対応モデルを利用する構成です。
比較軸 | xAI直API | Amazon Bedrock経由 |
|---|---|---|
認証管理 | xAIのAPIキーを自社で発行・保管します | AWS IAMのロール、ポリシー、短期認証情報を使えます |
請求管理 | xAIとの契約・請求体系で管理します | AWS Billing、コスト配分タグ、AWSアカウントで集約します |
監査ログ | 直API側の機能と自社実装を組み合わせます | CloudTrail、CloudWatch、アプリケーションログと統合しやすくなります |
ネットワーク | 直APIの接続仕様に従います | 対応構成ではPrivateLinkを用いたVPCエンドポイントを設計できます |
モデル切替 | 他社モデルを使う場合は別APIに合わせて実装します | Converse APIの対応範囲では実装を共通化しやすくなります |
新機能の反映 | 直APIが先行する場合があります | Bedrock側で対応するまで時間差が生じる場合があります |
料金 | xAIが定める単価と契約条件に従います | AWSが定めるモデル別・リージョン別単価に従います |
AWSを標準クラウドとして運用し、既存のロール設計、監査、請求統制へ生成AIを組み込みたい場合はBedrock経由が適しています。一方、xAI固有の機能を公開直後から利用することが業務要件であり、別途APIキー管理、ログ収集、費用配賦を維持できるなら、直APIを限定的に利用する判断もあります。
モデル評価の比較軸
モデル比較では、ベンダーが公表するベンチマーク順位だけで採用を決めません。業務で実際に扱う質問、帳票、コード、検索文書を匿名化して評価セットを作り、同じ指示、同じ検索結果、同じ出力制約で比較します。
評価項目 | 測定方法 | 本番判断への影響 |
|---|---|---|
業務正答率 | 正解データまたは専門担当者の採点で比較します | 基準未満なら対象業務を縮小します |
根拠の一致率 | 回答が参照文書の該当箇所を引用しているかを確認します | 根拠が示せない業務は人の確認を残します |
形式遵守率 | JSON、項目数、日付形式などの要件を満たす割合を測ります | 基幹連携前に検証ロジックを追加します |
安全拒否率 | 許可すべき依頼の拒否と危険な依頼の通過を分けて集計します | 過剰拒否ならルールを調整し、見逃しなら対象を制限します |
1件当たり費用 | 入力・出力・検索・再試行・ツール実行を含めて計算します | 人手処理費や予算上限を超えるならルーティングを見直します |
Grok 4.6を含む特定モデルを候補にする場合も、この評価表を同じ条件で適用します。Grok 4.6リリース!Grok 4.5からの変更点・料金と情シスの統制チェックポイントでは、企業利用で確認する項目を詳しく整理しています。
▶ 関連記事: Grok 4.6リリース!Grok 4.5からの変更点・料金と情シスの統制チェックポイント
▲ データ保管・リージョン要件に基づくモデル導入の判断フロー
Amazon Bedrockの料金体系とコスト試算
Amazon Bedrockのコスト管理では、モデルの入出力トークン費に加えRAGやログ保管を含めた総額試算が不可欠です。
料金を構成する課金要素
Amazon Bedrockの料金は、利用者数に応じた一律月額ではなく、モデル、リージョン、入力トークン、出力トークン、画像・音声などの処理量、利用方式で変動します。さらに、Knowledge Basesを使う場合は埋め込み、ベクトルストア、オブジェクト保存、検索基盤、ログ保管などの周辺AWSサービス費も発生します。
課金要素 | 主な発生条件 | 稟議時の見落とし |
|---|---|---|
入力トークン | プロンプト、検索文書、システム指示を送信したとき | RAGの検索結果を多く渡しすぎる費用です |
出力トークン | 回答、要約、コード、ツール呼び出し結果を生成したとき | 最大出力を無制限にする費用です |
キャッシュ | 共通プロンプトや長い文書を再利用したとき | 書き込み費と有効期限後の再作成費です |
バッチ推論 | 即時性が不要な大量処理を実行したとき | 対象モデル・対象リージョンの確認漏れです |
RAG関連費 | 文書の登録、埋め込み、検索、ベクトル保存を行うとき | 文書更新時の再取り込み費です |
ログ・保存費 | 監査ログ、プロンプト、出力を保存するとき | 保存期間を決めずにログを蓄積する費用です |
外部ツール費 | エージェントがSaaSや業務APIを呼び出すとき | API回数課金やライセンス増分です |
料金表の単価は、モデル追加やリージョン拡大で変わります。稟議には、確認日、AWSアカウント、リージョン、モデルID、入力・出力単価、為替前提を記録します。単価はAWS公式料金表(aws.amazon.com/jp/bedrock/pricing/)でリージョンとモデルIDを指定して取得し、その値で試算します。該当リージョンに掲載がなければ本番候補から外します。
主要モデル別の単価確認表
モデルの比較では、100万トークン当たりの入力・出力単価を同じ通貨、同じリージョン、同じ利用方式でそろえます。下表は、稟議書へ転記するための比較項目です。単価欄はAWS公式料金表の確認値を入力する運用とし、未確認の数値を推測で埋めません。
モデル分類 | 主な用途 | 100万入力トークン単価 | 100万出力トークン単価 | 料金判断 |
|---|---|---|---|---|
Amazon Nova Microなどの軽量モデル | 分類、短文要約、意図判定 | 公式料金表の確認値を記録します | 公式料金表の確認値を記録します | 大量処理の一次振り分け候補です |
Amazon Nova Proなどの標準モデル | 文書検索、文章作成、一般的な業務支援 | 公式料金表の確認値を記録します | 公式料金表の確認値を記録します | 品質と費用の基準モデル候補です |
Claude Haiku系の軽量モデル | 高速応答、定型分類、要約 | 公式料金表の確認値を記録します | 公式料金表の確認値を記録します | 出力品質を比較して採用します |
Claude Sonnet系の標準モデル | RAG、文書作成、コード支援 | 公式料金表の確認値を記録します | 公式料金表の確認値を記録します | 高難度処理への昇格候補です |
Grok 4.6などの対象モデル | 長文分析、複雑な推論、エージェント | 提供状況と単価が確認できた場合に記録します | 提供状況と単価が確認できた場合に記録します | リージョン・契約条件を満たす場合だけ比較対象にします |
固定単価を掲載しない理由は、料金を避けるためではありません。生成AIの月額は「単価×トークン量」で決まり、同じモデルでも入力量と出力量が10倍になれば費用も大きく変わるためです。情シスは単価表を契約資料として保存し、実測したトークン量と掛け合わせて初めて予算上限を設定できます。
月間10万件の費用シミュレーション
月10万件の社内問い合わせを処理し、1件当たりの平均入力を2,000トークン、平均出力を500トークンと仮定します。この場合、月間入力は2億トークン、月間出力は5,000万トークンです。モデルごとの公式単価をそれぞれ100万トークン単位で入力すれば、次の式で推論費用を計算できます。
月額推論費用=入力単価×200+出力単価×50+キャッシュ書き込み費+キャッシュ読み取り費+再試行分
項目 | 前提 | 月間数量 | 計算上の注意点 |
|---|---|---|---|
処理件数 | 月10万件 | 100,000件 | 繁忙月は通常月と分けて見積もります |
入力 | 1件当たり2,000トークン | 2億トークン | RAG文書やシステム指示も含めます |
出力 | 1件当たり500トークン | 5,000万トークン | 再生成やツール実行の出力を含めます |
再試行 | 例として2% | 2,000件相当 | タイムアウト、形式不備、業務上の再実行を測定します |
ログ保管 | 監査メタデータを1年間保存 | 実測値で算出 | 本文保存の有無で容量が大きく変わります |
たとえば、入力費用だけを比較して安いモデルを選んでも、長い出力や再試行が多ければ総額は逆転します。PoCで100件を実行し、平均値だけでなく95パーセンタイルの入力・出力トークンを記録します。95パーセンタイルが平均の3倍なら、平均値だけで月額を見積もると繁忙月の予算超過を見落とします。
コスト最適化の選択肢
AWSは、Amazon Bedrock Intelligent Prompt Routingで精度を損なわずコストを最大30%削減できると案内しています。単純な問い合わせを低コストモデルへ、難易度が高い問い合わせを高性能モデルへ振り分けられる業務では、全件を同じモデルへ送るより費用を抑えられます。
AWSは、対応モデルにおいてキャッシュされた入力トークンを標準入力トークンより最大90%安く課金すると説明しています。共通のシステムプロンプト、長い規程、ツール定義を繰り返し送る構成では、キャッシュ対象を測定します。月間入力費の60%が共通部分で、キャッシュ読み取りが通常入力の10%になるモデル条件なら、共通部分にかかる入力費用を理論上90%圧縮できます。ただし、キャッシュ書き込み費と有効期限後の再書き込み費を含めて実測します。
またAWSは、蒸留モデルが元のモデルより最大500%高速、最大75%安価であり、RAGなどの用途での精度低下が2%未満だったと説明しています。これはAWSが示す評価条件の結果であり、自社業務で同じ水準を保証する数値ではありません。標準モデルで作った評価セットを蒸留モデルにも適用し、正答率、根拠表示、JSON形式遵守率が業務基準内なら、一次処理への採用を判断できます。
夜間に処理できる文書要約、定期分類、帳票抽出は、対応モデルのバッチ推論へ移します。オンデマンド比で半額となる条件が確認でき、推論費用の40%をバッチ対象へ移せる場合、推論費用全体の削減見込みは20%です。即時回答が必要な問い合わせまでバッチ化すると利用者体験を損ねるため、処理期限を基準に分けます。
▶ 関連記事: ChatGPT Work・Gemini Spark・Claude Cowork徹底比較|情シスが押さえる選定基準と統制ポイント
用途別モデル設計とマルチモデル運用
全処理を高性能モデルへ集約せず、業務難易度とリスクに応じてモデルを分けると費用と応答時間を管理できます。
業務別のモデル配置
モデルルーティングとは、入力の種類、機密区分、必要精度、期限、業務影響を判定し、処理に適したモデルへ振り分ける設計です。特定のモデル名を固定するのではなく、「分類用」「検索回答用」「高難度分析用」のように役割で承認します。
処理層 | 主な用途 | 設計方針 | 人の関与 |
|---|---|---|---|
軽量処理 | 分類、短文要約、問い合わせ振り分け | 低コスト・短時間のモデルを優先します | 例外のみ担当者へ送ります |
標準処理 | RAG、文章作成、一般的なコード支援 | 根拠表示と出力形式の安定性を比較します | 重要文書はレビューします |
長文処理 | 複数文書の比較、長いコードの解析 | 検索で対象を絞ってから高性能モデルへ送ります | 結論と根拠を確認します |
実行処理 | 申請起票、マスタ更新、外部API呼び出し | 専用ロールと操作回数上限を設定します | 更新前承認を残します |
たとえば、全件を高性能モデルで処理していた業務の70%を軽量処理、20%を標準処理、10%を高難度処理へ分けると、高性能モデルの呼び出し件数は90%減ります。削減額はモデル単価と出力長に依存するため、導入前後で1,000件当たりの総費用を比較します。
ルーターに設定する判定項目
文字数だけでモデルを選ぶと、短いが高リスクな依頼と、長いが定型的な依頼を区別できません。ルーターには次の項目を持たせます。
機密区分が送信許可範囲内かを最初に判定します。許可範囲外ならモデルを呼び出さず、利用者へ代替手順を示します。
質問が分類、短文要約、定型回答なら軽量モデルへ送ります。
複数文書の統合、根拠付き回答、ツール利用が必要なら標準モデルへ送ります。
軽量または標準モデルの出力が品質基準に達しない場合だけ、高性能モデルへ昇格します。
法務判断、対外公開、送金、契約変更などは、モデルの種類にかかわらず人の承認を必須にします。
モデルを昇格させる条件は、曖昧な「難しい質問」ではなく、根拠文書が不足している、JSON検証に失敗した、コードテストが失敗した、担当者が再確認を選んだ、といった観測可能な状態で定義します。これにより、利用量が急増したときに、どの条件が高額モデルへの振り分けを増やしたのかを追跡できます。
モデル非依存のアプリケーション構造
モデルID、推論パラメーター、最大出力、ガードレールID、リージョンをソースコードへ埋め込む設計は避けます。アプリケーションは、共通API呼び出し層、モデル差分を吸収する変換層、業務ロジック、設定ストアの4層へ分けます。
設定を変更するだけでモデルを切り替えられる状態でも、品質が自動的に維持されるわけではありません。候補モデルへ同じ回帰テストを実行し、正答率、根拠の一致率、禁止情報の出力率、形式遵守率、平均費用、95パーセンタイル応答時間を比較します。全項目が基準内なら限定本番へ進み、1項目でも基準外なら旧モデルを維持して原因を分析します。
複数のAIエージェントやAI SaaSを含めた統制の比較は、ChatGPT Work・Gemini Spark・Claude Cowork徹底比較|情シスが押さえる選定基準と統制ポイントの判断軸も活用できます。
▶ 関連記事: MCP企業導入のセキュリティ完全ガイド|ガバナンスとリスク対策
▲ 処理難易度とコストに最適化したマルチモデル・ルーティング構成図

セキュリティ・ガバナンスの責任分界
Amazon Bedrockの安全性はAWSの機能だけで完結せず、利用企業が権限、データ分類、ログ、例外処理を設計して初めて確保できます。
AWSと利用企業の責任範囲
AWSはBedrockのサービス基盤、物理インフラ、マネージド機能を提供します。一方、利用企業は誰がどのモデルを使えるか、どのデータを入力できるか、RAGでどの文書を検索できるか、出力をどこに保存するかを決めます。Amazon Bedrockへ入力したデータをAWSが基盤モデルの学習に使用しないという方針と、自社が保存したプロンプトやログをどう管理するかは別の論点です。
管理領域 | AWS側の主な範囲 | 利用企業側の主な範囲 |
|---|---|---|
サービス基盤 | Bedrockのインフラとマネージド機能の運用 | リージョン、モデル、利用構成の選択 |
認証 | IAM連携機能の提供 | 最小権限、ロール分離、定期的な権限棚卸し |
通信 | 暗号化とPrivateLink対応機能の提供 | VPCエンドポイント、DNS、外向き通信制御の設計 |
データ | Bedrock上のデータ保護方針 | 入力可否、匿名化、保存期間、削除手順 |
出力 | Guardrailsなどの制御機能 | 業務ルール、承認フロー、誤回答時の対応 |
導入前セキュリティ・ガバナンスチェックリスト
以下の項目を稟議書、PoC計画書、運用手順書で合否判定します。すべてを一度に満たせない場合は、未達の項目に応じて用途を読み取り専用、匿名化データ、限定ユーザーへ縮小します。
確認領域 | 確認項目 | 確認できた場合 | 確認できない場合 |
|---|---|---|---|
業務目的 | 対象業務、責任者、成功指標が定義されていますか | 評価データを作成してPoCへ進みます | 目的を絞り、利用申請を差し戻します |
データ分類 | 入力データの機密区分と送信可否が決まっていますか | 許可区分だけで検証します | 公開情報または匿名化データだけを扱います |
リージョン | 推論先とデータ保管先が契約条件を満たしていますか | 本番候補の構成として記録します | 国内限定要件の業務から除外します |
権限 | 管理者、開発者、実行ロール、監査者を分離していますか | 最小権限で環境を構築します | 更新権限を持つエージェントを作成しません |
監査 | 利用者、モデル、トークン、停止理由を追跡できますか | 限定本番の監査対象にします | 本番データの利用を開始しません |
費用 | 部門別タグ、通知閾値、停止条件がありますか | 予算枠内で利用量を監視します | PoCの件数と出力上限を固定します |
例外処理 | 拒否、タイムアウト、形式不備、人への引継ぎを試験しましたか | 業務画面へエラー導線を実装します | 自動登録・自動実行を行いません |
権限分離と監査ログ
モデルを有効化する管理者、アプリケーションを実装する開発者、推論だけを実行するロール、ログを閲覧する監査担当者を分離します。開発者へすべてのモデルと本番データの権限を渡すと、検証用コードから高額モデルや機密データを利用できる状態になります。
監査ログには、実行者または実行ロール、日時、アプリケーション名、モデルID、リージョン、入力・出力トークン、応答時間、ガードレール判定、ツール呼び出し、検索文書ID、最終承認者を残します。プロンプト全文を保存する場合は、ログが新たな機密情報保管庫になるため、KMS暗号化、閲覧権限、マスキング、保存期間、削除手順を定義します。本文が不要な監査では、ハッシュ値とメタデータだけを保存します。
拒否応答と例外処理
生成AIのAPIはHTTPステータスが成功でも、モデルが安全上の理由で回答を拒否している場合があります。HTTPの成功だけを業務上の成功として扱うと、拒否文が基幹システムへ登録されたり、エージェントが同じ依頼を何度も再試行して費用が増えたりします。
アプリケーションでは、通信状態、モデルの停止理由、Guardrailsの介入、出力JSONの形式、ツール実行結果を別々に判定します。安全拒否なら再試行せず利用者へ理由を示して人の窓口へ引き継ぎます。形式不備なら最大1回だけ修正指示を与え、再度失敗した場合は未完了として記録します。外部システムを更新する操作では、対象、変更内容、根拠文書を表示し、人が承認した後に実行します。
規制と社内規程の整理
EU域内の利用者、顧客、拠点に関係するAIシステムは、EU AI Actの適用範囲を法務部門と確認します。高リスクAIに該当するか、汎用AIモデルを利用するシステムとしてどの文書化や透明性対応が必要かは、用途、提供形態、対象地域で変わります。EU向け提供がない国内業務でも、モデル台帳、データ区分、評価結果、インシデント連絡先を残せば、モデル変更時の説明責任を維持できます。
生成AIのAPIキー、外部ツール、MCP連携を含む設計では、接続先ごとに発行者、保管場所、利用ロール、失効方法、退職者の削除手順を記録します。【2026年8月最新】Claude Code企業利用の統制ガイド|APIキー管理・MCP連携・シャドーAI対策では、API利用の統制項目を解説しています。
▶ 関連記事: 【2026年8月最新】Claude Code 企業利用の統制ガイド|APIキー管理・MCP連携・シャドーAI対策
▲ Amazon Bedrock導入におけるAWSと利用企業のセキュリティ責任分界図
導入時のデメリットと失敗パターン
特定モデルへの密結合や拒否応答の見落としは、運用コストの急増やシステム障害を引き起こす原因になります。
特定モデルへの密結合
モデル固有のリクエスト形式、停止理由、モデルIDを業務ロジックへ直接記述すると、モデルを変更するたびに画面、処理、テストを広く改修することになります。マルチモデル基盤を採用しても、切替に数か月かかる設計では選択肢を生かせません。
共通API呼び出し、モデル固有変換、業務ロジック、設定管理を分離します。同じ評価セットを候補モデルへ実行し、設定変更だけで切り替えられる構成になっていれば、料金改定、性能差、リージョン要件の変化に対応しやすくなります。
長文RAGと推論ループによる費用増
検索結果を大量にプロンプトへ詰め込み、最大出力を大きく設定し、エージェントが同じツールを繰り返し呼ぶと、1件の依頼が数十回の推論へ増えることがあります。長いコンテキストを扱えるモデルでも、入力上限まで使うこと自体は品質保証になりません。
最大入力トークン、最大出力トークン、検索件数、ツール呼び出し回数、再試行回数、処理時間、1件当たり費用に上限を設定します。上限へ達した依頼を成功扱いにせず、人へ引き継ぐ理由を記録します。共通プロンプトのキャッシュ、検索結果の再ランキング、軽量モデルでの事前分類を組み合わせると、不必要な高額推論を減らせます。
過剰権限を持つAIエージェント
調査用エージェントに更新・削除・送信権限まで付与すると、誤った推論が実データの変更へ直結します。特に人事情報、顧客情報、支払情報、契約情報を扱う業務では、回答の正確さと操作の正確さを別のリスクとして扱います。
参照は自動実行、下書きは自動作成、公開は承認制、送金や契約変更は二者承認というように、業務影響で権限を段階化します。エージェントが変更する対象と根拠を画面で確認できる場合だけ承認付き更新を許可し、確認画面を作れない段階では読み取り専用に留めます。
4週間PoCの判定表
短期間のPoCでは、精度だけを追い続けず、毎週の成果物と中止条件を決めます。以下の判定表を利用すると、誰が何を判断するかを稟議前に整理できます。
期間 | 実施内容 | 成果物 | 判断条件 |
|---|---|---|---|
第1週 | 対象業務、データ区分、現状工数、責任者を定義します | 利用申請書、評価データ、リスク一覧 | 入力可能なデータと責任者を定義できなければ中止します |
第2週 | 2種類以上のモデルを同条件で比較します | 正答率、応答時間、費用、根拠表示の比較表 | 品質基準を満たす候補がなければ対象業務を縮小します |
第3週 | Guardrails、権限、拒否、障害、攻撃入力を試験します | 例外処理テスト結果、ログ設計書 | 危険な操作を遮断できなければ読み取り専用に変更します |
第4週 | 繁忙月費用、運用体制、停止条件を見積もります | 稟議書、監査手順、限定本番計画 | 予算上限と監査担当を設定できれば限定本番へ進みます |
生成AIのセキュリティを広く見直す場合は、【2026】生成AIセキュリティのベストプラクティスと情シス対策も、社内規程と運用手順を整える際の補足資料になります。
市場拡大と投資判断
セキュリティ費用を抑えて生成AIだけを先行導入する考え方は、事業継続の観点から危険です。矢野経済研究所は、「サイバーセキュリティ市場に関する調査(2026年)」において、国内サイバーセキュリティ市場(事業者売上高ベース)を2025年度予測1兆9,471億円(前年度比9.2%増)、2026年度予測2兆1,220億円と発表しています。生成AIの利用拡大に伴い、認証、ログ、データ保護、外部接続の管理も投資対象になっています。
生成AIの導入では、モデルへの入力だけでなく、RAGに保存する文書、エージェントが利用する認証情報、監査ログを攻撃対象として扱います。PoC予算には、推論費だけでなくログ保管、権限管理、脆弱性対応、運用担当の工数も含めます。
▶ 関連記事: 【2026】生成AIセキュリティのベストプラクティスと情シス対策
国内企業におけるAmazon Bedrockの活用事例
国内企業におけるBedrock活用では、対象業務を絞り込んだ段階的導入が業務時間の大幅削減につながっています。
数値で確認できる導入事例
以下はAWSが公開する事例(aws.amazon.com/jp/solutions/case-studies/)のうち、対象業務と成果数値を確認できる企業です。成果は各社がAWSへ報告した業務条件での測定値であり、測定対象・期間・算出方法は各事例ページで確認できます。同じモデルや機能を導入しても、文書品質、既存業務、承認工程が異なれば同じ効果を保証しません。
企業 | 業種 | 課題と施策 | 公開された成果 |
|---|---|---|---|
セゾンテクノロジー | ITサービス | HULFT Squareのアシスタント機能にAmazon Bedrockを活用しました | ユーザー満足度80%、業務効率24%向上を達成しました |
中外製薬 | 製薬 | 社内利用向けの生成AIアシスタントをAmazon Bedrockで開発しました | 6,000人が利用するアシスタントを2か月で開発しました |
LayerX | ソフトウェア・AI | 書類アノテーション基盤へAmazon Bedrockを活用しました | 1,000枚の書類で人手約165時間の作業を約1.5時間で完了しました |
EXNOA | デジタルコンテンツ | サーバーサイドコードの一次レビューへAmazon Bedrockを活用しました | 6.5MBのコード解析で約45分の一次レビューを完了しました |
タキヒヨー | 繊維・アパレル | Amazon BedrockとGenUを社内4部門へ導入しました | 合計で月450時間の工数削減を達成しました |
LayerXに見る帳票処理の設計
LayerXの事例は、生成AIを帳票処理へ適用する際に、対象作業を具体的に切り出す重要性を示しています。1,000枚の書類に対するアノテーション作業を約165時間から約1.5時間へ短縮したという成果は、単純なチャット利用ではなく、書類を処理可能なデータへ変換する業務フローへ組み込んだ結果です。
同種の業務では、いきなり抽出結果を基幹システムへ自動登録しません。まずは、抽出対象を取引先名、日付、金額、契約期間などに限定し、AIの結果と原文を並べて担当者が承認する画面を作ります。必須項目の見逃し率、誤抽出率、確認時間を測り、誤りの影響が小さい項目から自動化範囲を広げます。
中外製薬に見る社内展開
中外製薬は、6,000人が利用する生成AIアシスタントを2か月で開発したとAWS事例で公開しています。大規模な利用者へ展開する場合、モデルの回答精度だけでなく、認証、利用部門、入力可能データ、問い合わせ窓口、障害時の案内、利用ログの扱いを先に決める必要があります。
社内アシスタントを全社へ公開する前に、対象部門を絞り、質問分類、禁止入力、回答根拠、問い合わせエスカレーションを検証します。利用者の自由入力をすべて許可する方式よりも、まずは公開済み規程の検索、ITヘルプデスクの定型案内、文書要約のように、正解と対象データが明確な業務から始めると運用負荷を下げられます。
セゾンテクノロジーとタキヒヨーに見る効果測定
セゾンテクノロジーは、HULFT Squareのアシスタント機能でユーザー満足度80%、業務効率24%向上を公表しています。タキヒヨーは社内4部門で月450時間の工数削減を達成しました。どちらの事例も、導入効果を「AIを導入した」という事実ではなく、満足度、業務効率、削減時間という測定可能な指標で示しています。
自社のPoCでも、回答数だけでなく、導入前後の作業時間、担当者が調査に使った時間、差し戻し件数、利用者満足度、1件当たり費用を記録します。月450時間の削減をそのまま目標にするのではなく、自社の月間処理件数と従来工数を基準に、削減可能な時間を見積もります。たとえば月500件、1件当たり20分の確認作業を30%削減できれば、月50時間の削減見込みになります。
Amazon Bedrockに関するよくある質問
Amazon Bedrockの選定時に多い質問を、利用条件、料金、データ管理、Grok 4.6、ChatGPTとの違いに分けて整理します。
利用開始に必要な準備
Q. Amazon Bedrockの利用に必要なものは何ですか。
A. AWSアカウント、対象リージョン、IAM権限、利用するモデルへのアクセス設定が必要です。業務利用ではさらに、データ区分、費用負担部門、ログ保管先、責任者を利用申請へ記載し、入力可能な情報が定義できれば限定PoCへ進みます。
料金と月額予算
Q. Amazon Bedrockの料金はいくらですか。
A. Amazon Bedrockは一律月額ではなく、モデル別・リージョン別の入力と出力トークンを中心とした従量課金です。月額は、代表業務100件の実測トークンを月間件数へ掛け、RAG、ログ、再試行、外部ツール費を加えた金額で判断します。
入力データの扱い
Q. Bedrockへ入力したデータはモデル学習に使われますか。
A. Amazon Bedrockでは、入力と出力を基盤モデルの学習に使用しない方針が示されています。ただし、自社が保存するプロンプト、出力、RAG文書、監査ログには別途アクセス権と保存期間を設定し、不要になったデータを削除する手順を持ちます。
Grok 4.6の利用条件
Q. Grok 4.6はAmazon Bedrockで利用できますか。
A. 提供状況、モデルID、リージョン、料金は時期とAWSアカウントの利用条件で確認が必要です。本記事で参照した一次情報群にはAWSによるGrok 4.6の提供開始仕様が含まれていないため、公開済みの仕様としては断定せず、対象リージョンと料金が確認できれば評価対象に加え、確認できなければ別モデルでPoCを実施します。
ChatGPTとの選定基準
Q. Amazon BedrockとChatGPTはどちらを選ぶべきですか。
A. 社内システムに生成AIをAPIで組み込み、複数モデルをAWSの認証・監査・請求へ統合する場合はAmazon Bedrockを選びます。従業員が完成済みの対話画面で文章作成や要約を始めるだけなら、企業向けAI SaaSのほうが短期間で展開できます。
まとめ
Amazon Bedrockは、複数の基盤モデルをAWSのIAM、ネットワーク、監査、請求管理へ統合し、生成AIを業務システムへ組み込むための基盤です。導入可否はモデル数やベンチマークだけでなく、入力データ、リージョン、権限、監査ログ、例外処理、費用上限を設計できるかで決まります。
最初の一歩として、削減時間を測定できる業務を一つ選び、過去データ100件で複数モデルを比較します。入力・出力トークン、正答率、根拠表示、拒否応答、1件当たり費用を記録し、4週間のPoC判定表に沿って限定本番へ進める対象を決めます。夜間処理のバッチ化、共通プロンプトのキャッシュ、軽量モデルへの振り分けを組み合わせれば、品質を維持しながらAmazon Bedrockの料金を管理できます。


本記事の内容に誤り等がございましたら、こちらからご連絡ください。
監修
Admina Team
情シス業務に関するお役立ち情報をマネーフォワード Adminaが提供します。
SaaS・アカウント・デバイスの管理を自動化し、IT資産の可視化とセキュリティ統制を実現。
従業員の入退社対応や棚卸し作業の工数を削減し、情報システム部門の運用負荷を大幅に軽減します。
中小企業から大企業まで、情シス・管理部門・経営層のすべてに頼れるIT管理プラットフォームです。