

>
>
公開日
最終更新日
ログを見れば、改善対象が利用導線・FAQの不足・表記揺れ・参照データの鮮度のどこにあるかを切り分けられ、ツールを替えずに直せる範囲も見えてきます。
IPAが公開するプロジェクト報告書も、RAGの検索対象に含まれるノイズ・重複・古い情報が、誤回答や回答精度の低下につながると指摘しています。
本記事は、社内チャットボットの導入・運用を担当する情シス向けです。「使えない」「回答できない」と言われる5つの失敗パターンを整理し、ログ分析、運用体制の見直し、有人対応への引き継ぎという再構築3ステップを解説します。移行を検討する前に、現行ツールで直せる課題と、選定から見直す課題を整理できます。

なぜ社内チャットボット導入で失敗してしまうのか?
チャットボットは、導入後の更新担当や利用導線を決めないまま公開すると、使われなくなりやすい仕組みです。
本記事のポイント
最新の生成AIやRAGを用いたプロジェクトでも、導入しただけでは本番運用に定着しない。
定着させるには、質問しやすい利用導線とセキュリティガバナンスを導入前に設計しておく。
市場拡大の裏に潜む「運用の壁」
デロイト トーマツ ミック経済研究所の「自動対話システム市場の現状と展望 2026年版」は、国内の自動対話システム市場が2030年度に700億円規模を突破すると予測しています。ただし、市場が拡大しても、導入後の運用設計が不十分なままでは成果にはつながりません。
生成AI・RAGなら成功するという誤解
近年注目を集める生成AIやRAG(検索拡張生成)を取り入れたシステムにおいても、現実は甘くありません。生成AIを取り入れたパイロット案件が、そのまま本番運用に定着するとは限りません。従来のルールベース型だけでなく、最新AIを搭載したシステムであっても、事前の準備と継続的な運用設計がなければ失敗に終わります。
チャットボットに限らず、社内のあらゆる業務でAIを活用する全体像を知りたい方は、AIを活用した情シスの業務効率化と失敗パターンをまとめた完全ガイドを合わせてご参照ください。
社内チャットボット導入によくある5つの失敗事例
導入後に使われなくなる原因は、利用導線、更新体制、データの整え方、期待値の置き方に分けて見ると対処しやすくなります。
事例1:「詳しい人に聞いた方が早い」問題
新しいツールを単に公開しただけでは、従来の電話やビジネスチャットで直接質問するという習慣は変わりません。社内ポータルの奥深くにチャット画面を設置したり、検索の手間が直接質問する手軽さを上回ったりすると、社員はチャットボットを「使えない」と判断して敬遠します。Microsoft TeamsやSlackといった普段の業務で使い慣れたコミュニケーションツール内に窓口を統合しなければ、日常の業務フローに定着しません。ユーザーが直接質問するより早く、根拠付きの回答にたどり着ける導線を設計します。
事例2:メンテナンス不足による回答精度の低下
チャットボットの失敗の多くは、導入後の放置によって引き起こされます。質問されたが回答できなかったログを分析し、足りないナレッジを随時追加していくチューニング作業が不可欠で、officebot.jpのコラムによると、テスト運用時点の約200件のFAQを、未回答質問の分析を経て本公開までに約1,000件へ拡充した事例もあります。約1,000件という規模は対象業務の範囲や質問の複雑さで変わるため、自社の必要件数は未回答ログの件数から見積もります。専任担当者を置かず、他業務の片手間で運用を始めると、メンテナンスが後回しになりがちです。
事例3:「何でもAIが解決してくれる」というデータの丸投げ
企業が生成AIチャットボットを導入する際、失敗の主な原因の一つは「データの丸投げ」にあります。社内に散らばった大量のPDFやマニュアルを、そのままRAG(検索拡張生成)に読み込ませれば勝手に回答してくれると思い込むのは典型的な失敗パターンです。
事例4:社内用語や表記揺れへの未対応
従業員が入力する自然な言葉の揺らぎにシステムが対応していないと、本来存在するはずの回答に辿り着けません。例えば、「PCが動かない」「パソコンがフリーズした」「画面が固まった」など、同じ事象でも表現は人によって異なります。テスト運用で社員の検索語を収集せず、想定問答だけで公開すると、自己解決率が上がらないおそれがあります。社内FAQ・AIチャットボットの失敗を防ぐためにも、辞書機能や表記揺れ対策の設計は必須です。
事例5:「最初から回答精度95%」を求める過度な期待
「ツールさえ導入すればAIが勝手に学習し、ハルシネーション(嘘の回答)もゼロで完璧に応答してくれる」という経営層やプロジェクトチームの過度な期待が、現場の運用担当者を疲弊させます。生成AIは確率的に文章を生成するため、誤答をゼロにすることは困難です。許容できる誤答の水準は、経費精算・ITヘルプデスク・法務・人事といった業務ごとのリスクに応じて別々に定め、誤りの影響が大きい領域は有人対応に回す設計にします。この期待値コントロール(合意形成)を怠ると、運用初期のわずかな誤答を理由に「このシステムは使えない」と早々にプロジェクトが打ち切られる結果となります。
Teamsを日常の業務導線として活用したい場合は、Microsoft Teamsと連携した社内ボットの構築手順とセキュリティ対策を参考に設計を進めてください。
▶ 関連記事: Teams bot作成・導入ガイド|作り方と情シス統制ポイント
AI特有のハルシネーションによる失敗と具体的な防ぎ方
生成AIはもっともらしい嘘をつく特性があり、事実確認を怠ると誤った社内ルールが拡散する重大なインシデントに繋がります。
ハルシネーションとは何か
ハルシネーション(幻覚)とは、生成AIが事実に基づかない情報を、あたかも正しいかのように生成してしまう現象です。総務省は『令和6年版 情報通信白書』で、生成AIによって顕在化した重大なリスクの一つとしてハルシネーションを挙げています。IT知識が浅い社員はAIの回答を盲信しやすく、誤った経費精算や存在しない社内規定の適用といったトラブルに繋がります。例えば、AIドキュメントツールの回答を過信し、事実確認を怠ったまま不正確なデータが社内に流通してしまう課題も発生しています。情報システム部門はリスクを前提とした対策を講じる必要があります。
GraphRAGは精度向上の選択肢になるが、整備負荷もある
GraphRAG(ナレッジグラフ×RAG)は、文書の断片だけでなく、データ間の関係も検索に使う方式です。この方式は、部署・規程・申請条件などの関係をたどる質問で有効な場合があります。ただし、規程や組織の改定が頻繁で関係データの更新が追いつかない場合や、重複・古い文書の除去、見出しの構造化、メタデータ付与といった通常検索の改善が済んでいない場合は、そちらを先に行うほうが効果を得やすくなります。関係データの整備不足や検索設計の誤りがあれば誤回答は残るため、対象を絞った事前検証も欠かせません。
「答えない」ガードレール設計と根拠の明示
ハルシネーション対策の一つとして、AIに「わからないことに対しては『わかりません』と正しく答えさせる(ハルシネーションガードレール)」設計を実装します。また、回答の根拠となった社内マニュアルの該当箇所や参照リンク(URL)を必ず同時に提示させる仕様にすることで、ユーザー自身が一次情報にアクセスして確認できるプロセスを確立します。
生成AIの仕組みと、導入時のリスクや運用の考え方は次の記事で解説しています。
▶ 関連記事: 生成AIとは?導入のメリット・リスクと実務での活用・運用術
失敗をリカバリーする社内チャットボット再構築の3ステップ
形骸化したチャットボットは、いきなりリプレースせず、未回答ログと離脱ログから対象業務を絞って立て直します。
ステップ1:失敗原因の可視化とKPIの再設定
まずは現状の利用ログを抽出し、ユーザーがどの回答で不満を抱いているか、回答未提示となった質問にどのような傾向があるかを可視化します。「すべての質問に答える」という不可能な目標は捨て、反復して発生する「経費精算の手続き」「パスワードのリセット」など、問い合わせ件数の多い特定ドメインにターゲットを絞ります。ログは「未回答(回答を出せなかった)」「誤回答(回答は出たが内容が誤り・古い)」「導線離脱(質問直後に有人へ転送された、または同じ質問を言い換えて再入力された)」の3つに分けて集計します。KPIは該当領域の自己解決率だけでなく、再問い合わせ率、有人転送率、根拠リンクの閲覧率、重大誤答の件数も併せて追い、自己解決率が高くても重大誤答が出ていないかを確認します。これがチャットボット改善に向けた最初のプロセスです。
ステップ2:企業規模別の無理のない運用体制構築
運用担当者と更新頻度を決めなければ、規模にかかわらず回答データは古くなります。
最小構成:情シスの兼任担当者が、未回答ログ(ログデータ)を定期的にチェックし、不足しているFAQを追加・修正する運用から始めます。人事・法務など誤回答の影響が大きい領域を扱う場合は、回答の事前レビューと有人エスカレーションを加えます。
複数部門の知見が必要な場合:総務・人事・情シスから担当者を選出し、定例ミーティングを設けて社内ナレッジの共有とデータ更新を行う体制を築きます。
対象領域が広い場合:システムの稼働状況を継続監視するヘルプデスク担当者を置き、辞書登録や表記揺れ対応といったチューニング作業を標準業務に組み込みます。対象をITヘルプデスクなど特定業務に絞るなら、兼任の少人数でも運用できます。
ステップ3:有人対応へのシームレスな移行(有人エスカレーション)
全問い合わせをボットだけで処理する前提では設計しないでください。回答不能時の受け皿まで含めて運用を設計します。ボットが回答できなかった場合、あるいはユーザーが「解決しなかった」と判定した場合には、ワンクリックで情シスの有人チャットや起票システムへとシームレスに引き継ぐ「有人エスカレーション」の動線を必ず用意します。これにより利用者の不満蓄積を防ぎ、同時に情シスは「何が解決できなかったか」という貴重な未登録データを確実にキャッチして改善に繋げることができます。
生成AI型(RAG)で再構築する場合は、RAGの仕組みと情シス向けの導入手順を確認してください。
▶ 関連記事: 【2026年最新】RAGとは?仕組み・最新動向と情シス導入手順
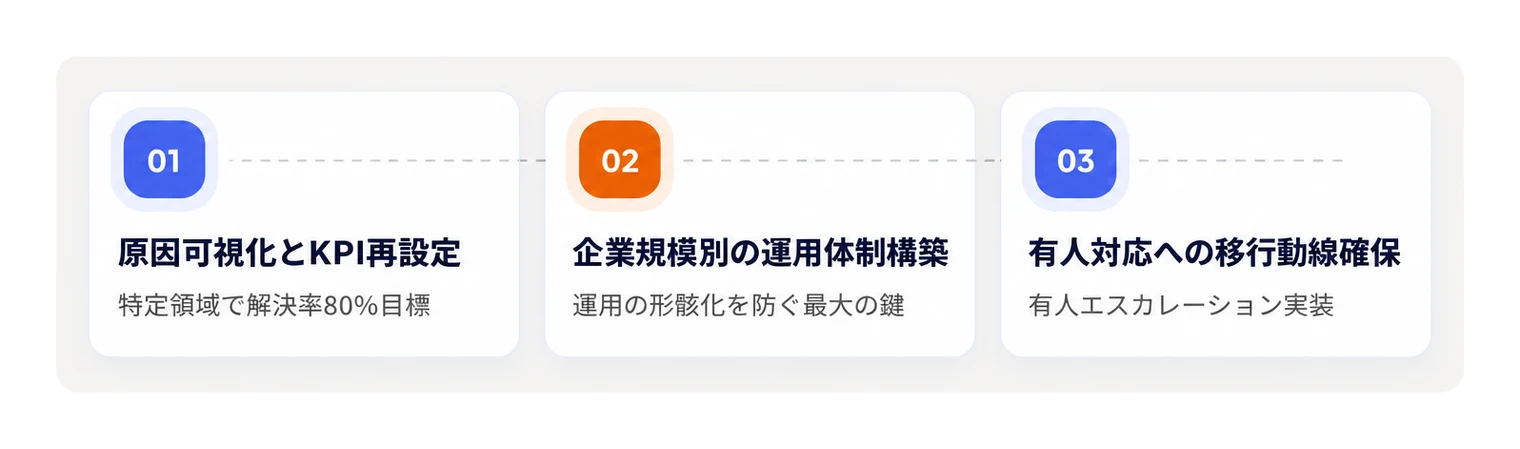
▲ 形骸化した社内チャットボットをリカバリーするための再構築3ステップです。
失敗しない社内チャットボットの選び方とツール比較
シャドーAIによる情報漏洩リスクを防御し、自社のFAQ整備状況と予算に合わせたシステム構成を選択してください。
「シャドーAI」対策としての公式チャットボット導入
従業員が会社の承認を得ないまま生成AIを業務で使うシャドーAIは、社内チャットボットの選定時に避けて通れない論点です。これは、機密情報の漏洩やJ-SOX(内部統制)の実効性毀損など、深刻な経営リスクです。ツール選定の軸は利便性ではなく、機密情報がAIの学習に使われない環境を公式に整備し、シャドーAIの利用を減らすガバナンスにあります。公式ツールを用意しても私的利用が完全になくなるわけではないため、学習利用の有無に加え、入力ログの保存期間、データの保管リージョン、ログのマスキング可否、閲覧権限の範囲を候補ごとに比べ、自社の情報管理規程に合わないサービスは候補から外します。
「シナリオ・FAQ・生成AI」のハイブリッド運用
すべてを生成AI(RAG)で解決しようとするアプローチは失敗を招きます。型ごとの回答の仕組みと運用負担は下の比較表で整理しており、問い合わせの性質に合わせて型を使い分けます。
主要な社内チャットボットシステムの比較表
導入費用と運用フェーズのバランスを考慮してシステムを選択します。
比較項目 | シナリオ型 | AI型(自然言語処理) | 生成AI型(RAG対応) |
|---|---|---|---|
回答の仕組み | 選択肢による条件分岐 | 質問文の意図解析 | ドキュメントからの文章生成 |
事前準備の負担 | シナリオ作成が必須 | 学習データの登録が必須 | マニュアルの整理(重複・古い情報の除去、チャンキング、見出しの構造化)と、回答評価・ガードレールの設計 |
運用時の負担 | 選択肢の追加・修正 | 表記揺れ対応・辞書登録 | 参照元ドキュメントの最新化 |
セキュリティ要件 | 外部連携先の有無と、連携先での保管条件 | 解析基盤での入力データの扱い(保存期間・リージョン) | 学習利用の有無・保存期間・リージョン・ログマスキングを契約条件で照合 |
情シス向け:導入可否の判断フロー(実務チェックリスト)
準備不足のまま導入しても失敗します。以下の3つのステップで、自社の受け入れ態勢を診断してください。
STEP 1:頻出する定型問い合わせが発生しているか?
反復する定型的な質問が少ない場合は、導入しても費用対効果が見合いにくいため、手動対応を維持するか他の効率化手段を検討します。STEP 2:参照元となる業務マニュアルは明文化されているか?
元のデータが不正確・未整備な状態では、AIは正しい回答を出せません。まずは簡単なドキュメントやFAQの整備から開始してください。STEP 3:導入後にメンテナンスを担当するリソースを確保できるか?
ログ分析やデータの更新を担当する人員をアサインできない場合、情報の陳腐化が進み、ボットの回答精度は低下しやすくなります。体制を組めることを確認してから、ツールの本格選定へと進んでください。
チャットボットの先にあるAIエージェントの導入とガバナンスは、情シス向けの実務ガイドで解説しています。
▶ 関連記事: AIエージェントのセキュリティと情シス向けガバナンス実務ガイド

▲ 社内チャットボットの主要な3方式における回答の仕組みや負担の比較です。
よくある質問
社内チャットボットの導入・運用に関する疑問を解消し、失敗リスクを最小限に抑えることがプロジェクトの成功に直結します。
Q:チャットボットが使えないと言われる主な理由は何ですか?
A:主な理由は、利用導線が社内ポータルの奥深くにありアクセスしにくいことや、表記揺れに対応しておらず「求める回答にたどり着けない」点です。また、データのメンテナンスが不足し、古い情報が放置されていることも社員が離脱する大きな原因です。
Q:失敗を回避するための事前準備として、何を行うべきですか?
A:まずは直近1ヶ月の問い合わせ履歴を棚卸しし、自動化する「定型質問」を絞り込むことです。また、AIが参照する社内マニュアルやドキュメントを最新の状態に整理し、入力データがAIの学習に利用されないセキュアなツール環境を選定しておくことが不可欠です。
Q:社内チャットボットの失敗事例から、どのような学びが得られますか?(業種別)
A:製造業などの現場では、ITリテラシーに左右されないシンプルなUX設計が不可欠であるという点です。また、多種多様なナレッジを扱う流通業やサービス業では、回答対象のFAQを絞り込む「引き算の設計」が、自己解決率を高める施策の一つになります。
Q:リプレース・改善判断を下すべきタイミングはいつですか?
A:導入後3ヶ月〜半年が経過しても自己解決率が上がらない場合、あるいは「回答未提示ログ」に対するチューニングが構造上困難なツールである場合です。このような兆候が見られたら、未回答ログを「FAQ未登録」「表記揺れ」「導線の問題」「ツール機能の制約」に分類します。前の3つが大半を占めるなら運用改善で解消できるため現行ツールを継続し、辞書登録や参照元の更新といったチューニング自体がツールの機能上できないログが多数を占める場合に、生成AI/RAG型ツールなどへのリプレースを検討します。
Q:生成AI(RAG)を導入すれば、FAQの登録やメンテナンスは不要になりますか?
A:いいえ、むしろ「運用の再設計」が必要です。生成AIは社内ドキュメントを読み込んで回答を作成するため、大元のマニュアルやFAQが不正確だったり、古い情報だったりすると、嘘の回答(ハルシネーション)の原因になります。導入後も、定期的にドキュメントを更新・削除する体制が不可欠です。
Q:個人情報の保護や機密情報の取り扱いはどうすべきですか?
A:学習への利用可否はAPI経由かどうかでは決まらず、サービスごとの契約条件や利用規約で定まります。候補ごとに学習利用の有無、データの保存期間、保管リージョン、ログのマスキング可否を契約書・利用規約で照合し、自社の情報管理規程に合わないものは候補から外します。総務省と経済産業省は、既存の3つのAI関連ガイドラインを統合した「AI事業者ガイドライン」(2024年4月に第1.0版、2026年3月31日に第1.2版へ改定)を公表しており、社内利用規約はシャドーAI対策と合わせたガバナンス体制の一部として整えます。
社内問い合わせの工数削減と属人化を防ぐツール比較は、次の記事で解説しています。
▶ 関連記事: 情シスの社内問い合わせ工数削減|属人化を防ぐツール比較

▲ チャットボットのリプレースや運用の見直しを判断するためのフローです。
まとめ
社内問い合わせの自動化に向けた最初の一歩
社内チャットボットの導入や再構築を成功させるためには、高度なITツールの選定よりも、自社のリアルな課題を正確に把握することが先決です。システムを急に導入するのではなく、現場で日々発生しているコミュニケーションのボトルネックを可視化することから始めましょう。
形骸化やハルシネーションによる失敗を減らし、工数削減につなげる第一歩は、「直近1ヶ月の問い合わせ履歴の棚卸し」です。どのような質問が、誰から、何件寄せられているのかを定量的に可視化すると、ハイブリッド型チャットボットやRAGシステムの設計を検証する起点になります。
✅ 直近1ヶ月の問い合わせ履歴を棚卸しし、定型質問TOP10を特定する
✅ 参照元となる社内マニュアル・ドキュメントの鮮度と正確性を確認する
✅ 導入後のメンテナンスを担当するリソース(担当者)をアサインする
✅ 入力データがAI学習に利用されないセキュアなツールを選定する
✅ 有人エスカレーションへの引き継ぎ動線を設計する


本記事の内容に誤り等がございましたら、こちらからご連絡ください。
監修
Admina Team
情シス業務に関するお役立ち情報をマネーフォワード Adminaが提供します。
SaaS・アカウント・デバイスの管理を自動化し、IT資産の可視化とセキュリティ統制を実現。
従業員の入退社対応や棚卸し作業の工数を削減し、情報システム部門の運用負荷を大幅に軽減します。
中小企業から大企業まで、情シス・管理部門・経営層のすべてに頼れるIT管理プラットフォームです。





