
>
>
公開日
最終更新日
情シス担当者が業務システムにAIを組み込む場面では、Jevは文章ではなく「どの選択肢か」「何点か」「何%の確率で真か」を返す部品として使えます。
TypeSafe AIは、2026年9月15日にJevの早期アクセス提供を開始しました。公表された応答時間はエンドツーエンドで70〜500ミリ秒です。料金は入力100万トークンあたり0.042ドルで、出力料金は無料と案内されています。
本記事では、JevとLLMの使い分け、Choice・Score・Noulの仕組み、導入時に決めるべき確信度のしきい値と誤判定時の対応を解説します。
Jevとは?TypeSafe AIが早期アクセス公開した新型AIモデルの概要
Jevは、文章を生成する代わりに型が保証された判断結果を返すことに特化した、TypeSafe AIの第一弾公開モデルです。既存のLLMを置き換える汎用チャットAIではなく、ソフトウェアの内部で使う「判断エンジン」という新しいカテゴリの製品として発表されました。
Diogo Almeida氏は、米サンフランシスコを拠点とする同社の共同創業者兼CEOです。同氏は元OpenAIの研究者で、InstructGPT論文の著者にも名を連ねています。同社ブログでは、OpenAIで言語モデルが指示に従い人と対話できるようにする手法の開発に携わったと述べています。同社ブログの発表文によれば、Almeida氏は「モデルは何年も前から対話では超人的なのに、なぜ自動化が進まないのか」という問いを4年間追い続け、約2年間の非公開開発を経て今回の発表に至ったとしています。同社はこの新しいモデル群を「System One Model」と呼び、Jevはその最初の公開モデルという位置づけです。
名称の由来も公式ブログで説明されています。「System One」は、心理学者ダニエル・カーネマンの著書『ファスト&スロー』における、速く直感的な「システム1」思考と、遅く熟考的な「システム2」思考の対比から取られています。また「Jev」は経済学者ウィリアム・スタンリー・ジェヴォンズにちなんだ名前で、同社は、蒸気機関の効率化が石炭の需要増につながったのと同じ道筋を機械の知能もたどり、「知能のコストが1桁下がるたびに、用途が桁違いに広がる」と見ています。
早期アクセスは2026年9月15日の発表当日から始まり、同社は発表時点でウェイトリスト登録者へ順次案内するとしていました。2026年10月14日には改良版のJev 1.14が公開され、多言語対応の改善などが加えられています。企業として本格導入を検討するにはまだ情報が少ない段階であることを踏まえ、まずは非機密データでの検証から始めることをおすすめします。
▶ 関連記事: Claude Fable 5.1とは?料金体系と移行の注意点
LLMと何が違う?Jevの仕組み|Choice・Score・Noulという3つの質問形式
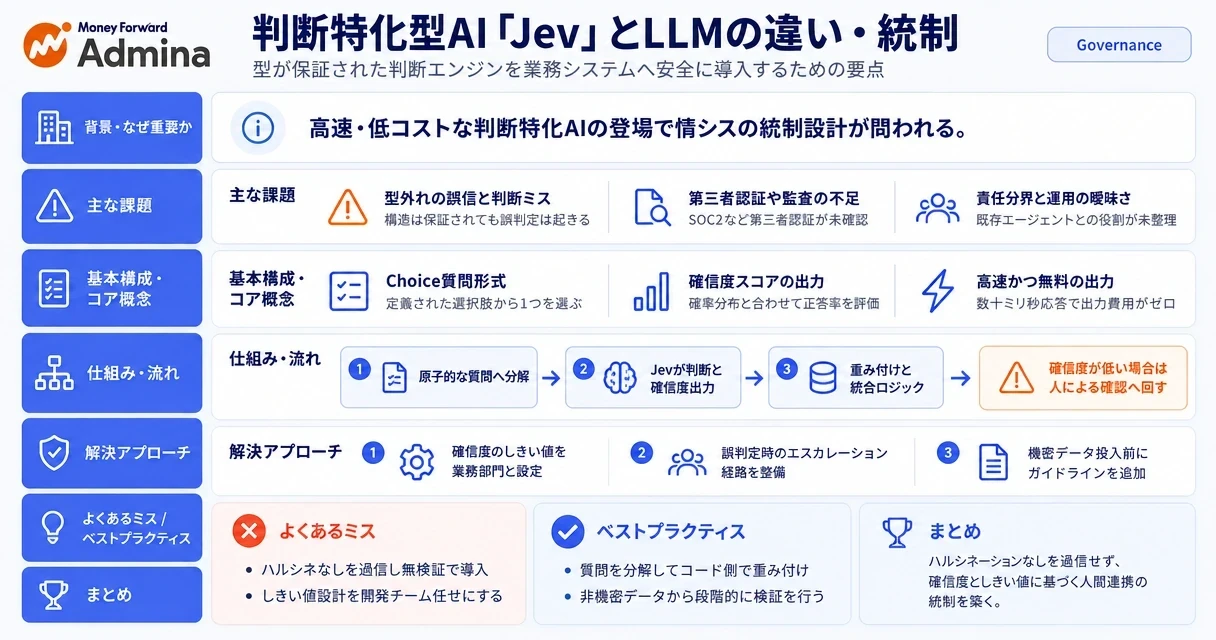
JevとLLMの最大の違いは、あらかじめ定義した選択肢や評価尺度に沿った構造化データを直接返すか、自由な文章を生成してから解析するかという点にあります。
公式ドキュメントによれば、Jevは「Choice」「Score」「Noul」という3種類の質問(primitive)を扱えます。3つの違いを整理すると以下の通りです。
質問形式 | 目的 | 返り値 |
|---|---|---|
Choice | 選択肢の中から1つを選ばせる | 選択結果・確率分布・確信度 |
Score | 評価尺度に沿って採点させる | スコア・確率分布・確信度 |
Noul | ある記述が真である確率を問う | 0〜1の確率値 |
使い方の例として、事業案の説明を入力し、市場規模や技術的な実現性を別々に採点させたうえで、独自の計算式で統合するといった活用が紹介されています。
開発元が推奨する設計思想は「原子的な質問を組み合わせる」ことです。「この事業案を評価して」のような複合的な判断を一度に求めるのではなく、市場規模・技術的実現性・差別化要因といった要素ごとに質問を分解し、その結果を自社のロジックで重み付けして統合することが推奨されています。優先順位が変わった場合もプロンプトを書き直すのではなく、コード側の係数を変えるだけで済むという利点も説明されています。
学習方法にも違いがあります。既存のLLMの多くは、人間の評価を報酬とするRLHF(人間のフィードバックによる強化学習)や、プログラム的に検証可能な報酬を使うRLVRで最適化されています。これに対しJevについて開発元は、独自開発の「Reinforcement Learning for Calibrated Decisions(RLCD)」で、較正された判断を返すよう学習したと説明しています。既存モデルとの違いは、対話の品質ではなく、判断に付く確率が実際の正答率と一致すること(較正)を最適化の対象にしている点です。
▶ 関連記事: 生成AIとは?導入のメリット・リスクと実務での活用・運用術
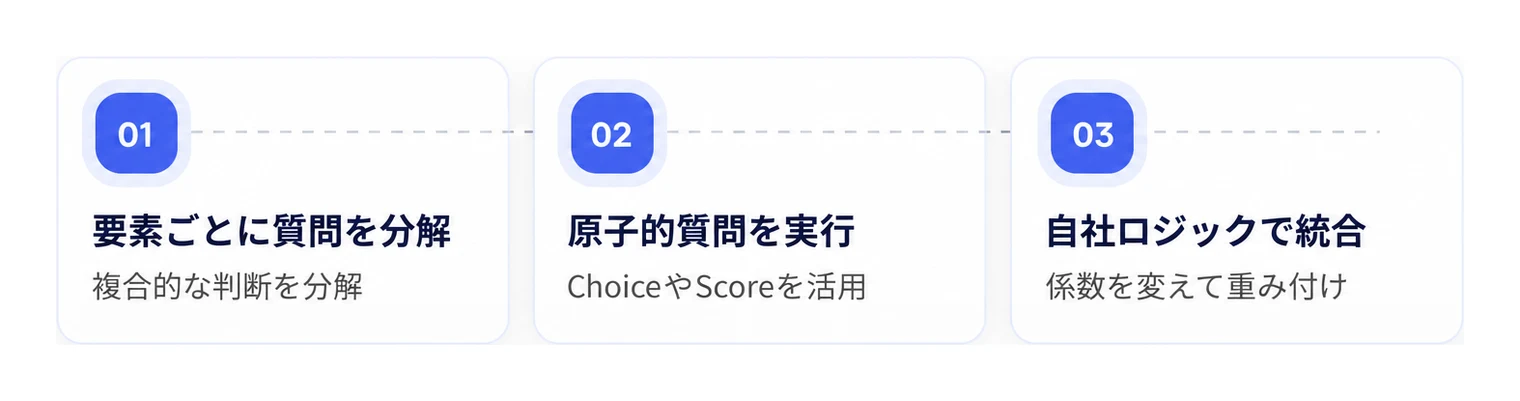
▲ 複合的な判断を原子的な質問に分解し、自社のロジックで統合するJevの設計思想。
速度とコストの違い|LLMとの比較でわかるJevの位置づけ
開発元は、Jevが既存LLMより高速かつ低コストで、リアルタイム性が求められる自動化処理に向くと説明しています。
公式ブログは、Jevのエンドツーエンド応答時間を70〜500ミリ秒と公表しています。料金は発表時点で入力100万トークンあたり0.042ドル、出力トークンは無料です。2026年10月14日に公開された最新版のJev 1.14も、公式の料金表では同じ価格です。既存LLMとの違いを整理すると以下の通りです。
項目 | 既存のフロンティアLLM(開発元が比較に用いた公表値) | Jev |
|---|---|---|
出力価格 | 入力の約5倍 | 無料 |
サンプリング方式 | 逐次(トークンを1つずつ生成) | 並列(全回答を1回で出力) |
TypeSafe AIは公式ブログで、System One型の問い合わせでは同等の知能水準を持つフロンティアLLMと比べて40〜200倍高速だと説明しています。
同社はこの速度・コスト差を検証するため、業務フローを想定した独自の評価(workflow evals)も公開しました。TypeSafe AIによると、この評価は各モデルの判断結果を「もっとも賢く高価な外部モデルの平均」と比較する形式で、参照モデルにはGPT-6 AstraとClaude Fable 5.1を使っています。
同社が公開したサイド・バイ・サイドのデモでは、比較対象としてGPT-5.6のTerraモデル(デフォルトの推論設定)が使われました。同社は、このモデルが平均的な知能水準でJevと最も比較しやすかったためと説明しています。速度・コストの数値はいずれも自社のベンチマークによるものであり、独立した第三者検証はまだ限定的である点は差し引いて捉える必要があります。
▶ 関連記事: GPT-6 Astra発表|サイバーセキュリティCritical到達の意味と情シスの統制ポイント
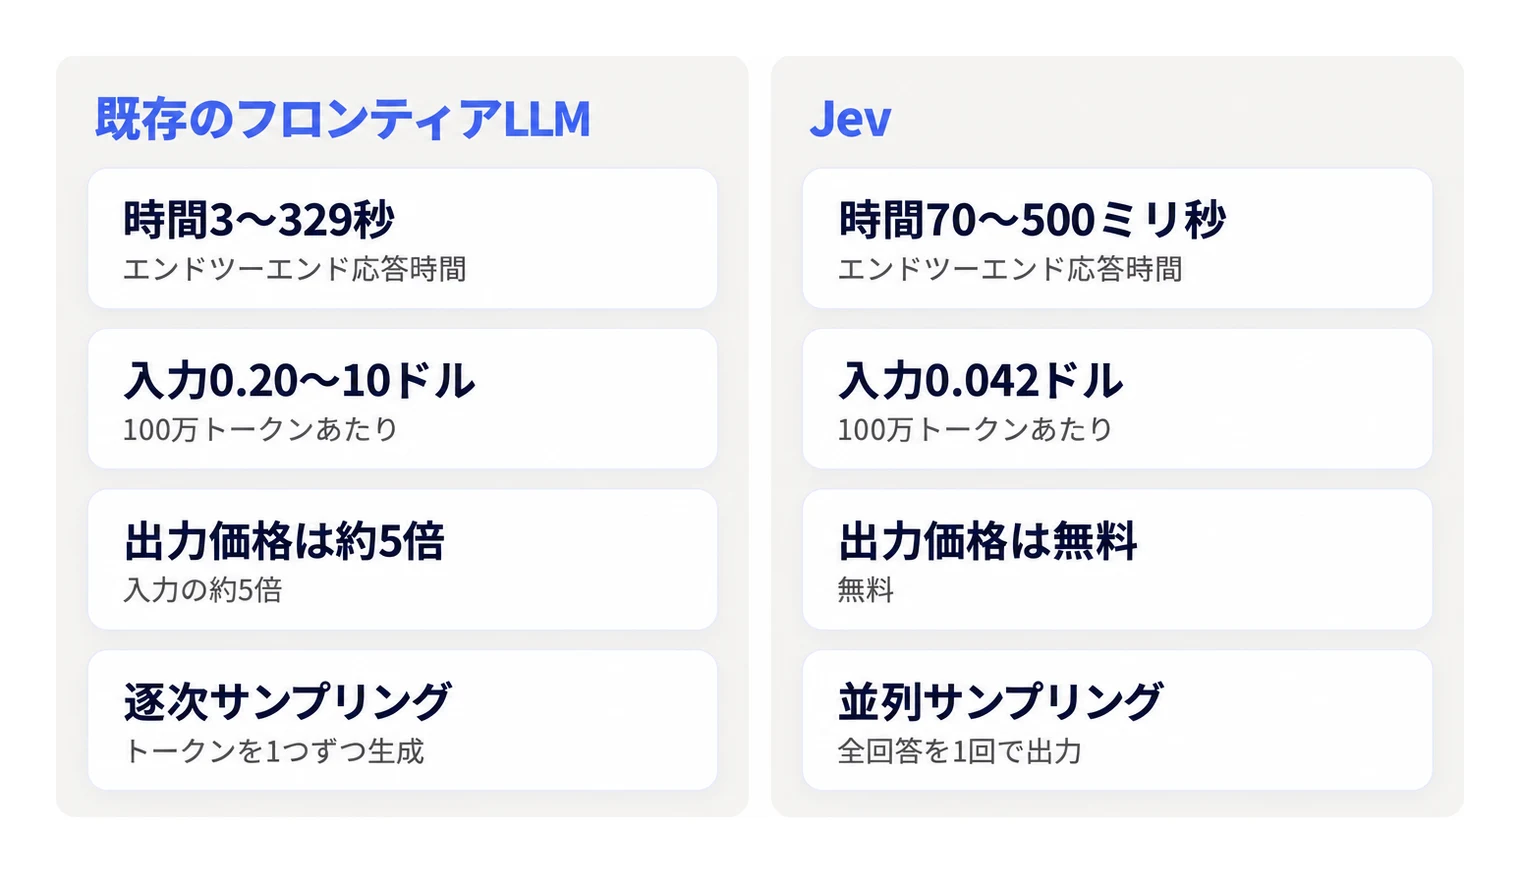
▲ 既存のフロンティアLLMとJevにおける応答時間やコスト、サンプリング方式の比較。
「ハルシネーションなし」の意味と確信度の考え方
同社が掲げる「ハルシネーションなし」という表現は、指定した選択肢やデータ構造から外れた出力が原理的に発生しないという意味であり、判断そのものの正しさまで保証するものではない点に注意が必要です。
同社は公式ブログで、Jevが選択肢にない答えや指定したデータ構造に合わない出力(型エラー)を返すことは数学的に起こり得ないと説明しています。一方、Forbes JAPANの寄稿記事は、自由な文章による作り話を防ぐことと、正しい答えを保証することの違いを取り上げています。情シスは、型どおりに返ることと判断が正しいことを分けて評価する必要があります。
この「判断の正しさ」を補うのが確信度(confidence)の仕組みです。開発元は、JevをRLCDで学習した、較正された判断を返すモデルと説明しています。確信度がしきい値を上回れば自動処理を継続し、下回れば人による確認に回すという設計は、既存の生成AIエージェントの運用でも使われる、人の確認を処理の途中に挟むHuman-in-the-loop設計の一種です。
▶ 関連記事: GPT-5.6(Sol/Terra/Luna)7/9一般公開|情シス向け機能・価格・リスク・導入判断
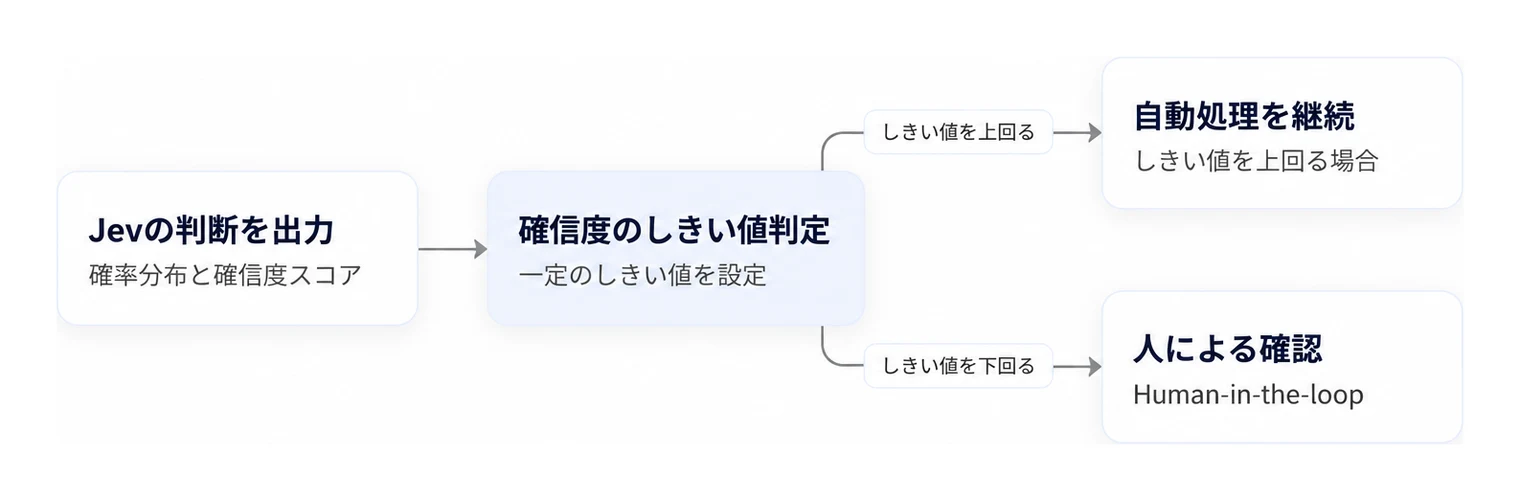
▲ 確信度スコアとしきい値の比較により自動処理と人手確認を切り替える運用フロー。

情シス業務での活用シーン|ワークフロー組み込みとガードレール利用
Jevはチャットボットの代替ではなく、既存の業務システムに埋め込んで使う「賢いif文」という位置づけです。
開発元が公式に挙げている用途は、大きく4つに整理できます。
用途 | 内容 |
|---|---|
AI-Powered Workflows | 分類・ルーティング・採点・抽出・分岐など、手書きロジックでは対応しきれない曖昧な判断を担わせる |
Map-reduce型のデータ処理 | 大量データに対するマップリデュース処理で、特徴量やインサイトに変換する |
リアルタイムアプリケーション | UXがシビアな場面へのAI組み込み |
Verify everything | LLMのプロンプト・推論過程・出力を採点・判定・ガードレールし、プロンプトインジェクションのようなジェイルブレイクを検知する |
情シス業務では、分類・ルーティング用途が身近です。この用途は、問い合わせの振り分けのようにAdmina AIヘルプデスクのような既存の自動化基盤が担う領域と重なります。
開発元が「Verify everything」として挙げる用途は、既存の生成AIエージェントの出力や推論過程を検証するガードレイヤーとしての使い方です。AIエージェントの暴走や不適切な出力を防ぐ仕組みの一部に、低コストで応答の速い判定モデルを組み込む形になります。MCP経由で複数のAIツールをワークフローに組み込んでいる企業であれば、MCPの接続先を管理している統制の枠組みに、Jevのような判断特化型AIも接続先の一つとして加え、ほかの接続先と同じ基準で管理します。
▶ 関連記事: AIエージェントのセキュリティと情シス向けガバナンス実務ガイド

データの取り扱いとセキュリティ
TypeSafe AIのプライバシーポリシーは入力データを学習に利用しない方針を明記し、公式エンタープライズページはSOC 2 Type IIレポートをTrust Centerで請求できると案内しています。一方、SSO・RBACなどのアクセス制御機能の仕様はプライバシーポリシー、公式ドキュメント、エンタープライズページのいずれにも示されておらず、これらを必須要件とする組織は、同社への問い合わせで対応可否が分かるまで機密データの投入を見送る判断になります。
同社のプライバシーポリシー(2025年11月19日更新)は、ユーザーが送信するプロンプト・データ・指示(Input)を「いかなるAI・機械学習モデルの学習・ファインチューニングにも利用しない」と明記しており、Inputの開示先もサービス提供者に限っています。同社は公式ドキュメントでも、顧客のリクエストとレスポンスを学習に使わないことと、エンタープライズ顧客向けにゼロデータ保持(ZDR)のオプションを用意していることを説明しています。一方で、同ポリシーによるとサービスは米国でホストされており、EEAや英国など米国外の利用者の個人データは米国に移転されます。セキュリティ面の記載は「合理的な対策を講じる」という一般的な表現にとどまります。
Jevは早期アクセス段階のプロダクトです。無料の実験用途であればともかく、社内の機密情報や顧客データを扱うワークフローに組み込む前には、社内のベンダー評価の基準に沿って、セキュリティ資料の提示やデータ処理契約(DPA)の締結可否を個別に問い合わせることを推奨します。
▶ 関連記事: 生成AIセキュリティのベストプラクティス|シャドーAI検知と対策
導入前に情シスが確認すべき統制ポイント
Jevのような判断特化型AIを業務システムに組み込む際は、通常のSaaS導入チェックに加えて「確信度のしきい値設計」「誤判定時のエスカレーション経路」「既存AIエージェントとの責任分界」という3点を確認する必要があります。
確認項目 | 何を決めておくか |
|---|---|
① 確信度のしきい値設計 | しきい値を誰が設定するか、業務部門と情シスの合意プロセス |
② 誤判定時のエスカレーション経路 | 誰が誤りに気づき、どう是正するかのフロー |
③ 既存AIエージェントとの責任分界 | 対話型AIエージェントとJevのどちらがどの業務判断に責任を持つか |
1つ目は、確信度のしきい値を誰がどのように設計するかという点です。Jevは確信度が低い判断を人による確認に回す運用を想定していますが、そのしきい値をどの水準に設定するかは業務部門と情シスが共同で決める必要があります。しきい値の設計を開発者任せにすると、意図せず自動承認の範囲が広がるリスクがあります。自社の過去データから抜き出したサンプルを確信度の帯(例:0.9以上、0.7〜0.9、0.7未満)に分けて実測の正答率を出し、その結果を見てしきい値を決め、運用開始後も月次で同じ集計を繰り返して、正答率が下がった帯のしきい値を引き上げる運用が考えられます。
2つ目は、誤判定が起きた際のエスカレーション経路です。問い合わせの振り分けのように誤りの影響が小さい業務では、確信度がしきい値未満の案件だけを担当者の確認に回し、アクセス権限の付与や支払いに関わる判断では確信度にかかわらず人が最終承認してJevの出力は推奨として扱うなど、業務リスクごとにフォールバックを分けます。「ハルシネーションなし」という表現に対する過信を避け、判断を誤った場合に誰が気づき、どのように是正するかのフローを事前に決めておく必要があります。AIの誤動作を前提にしたインシデント対応の手順を、Jevのような判断特化型AIにも適用します。
3つ目は、既存の生成AIエージェントとの役割分担です。対話型のAIエージェントと、Jevのような判断特化型AIを併用する組織が増えていくと考えられます。どちらのAIがどの業務判断に責任を持つのかを明確にしておかないと、インシデント発生時に原因の切り分けが難しくなります。APIキーの発行・利用範囲についても、他のAI関連サービスと同様に一元管理する体制を整えておくことが重要です。
▶ 関連記事: AIガバナンスの実装手順|ISO42001対応とシャドーAI対策
企業規模別:情シスが「今」やるべきこと
組織規模に関わらず、「機密データを投入する前に確認の土台を整える」という順序は共通していますが、優先すべき対応は規模によって異なります。
企業規模 | 情シスが今やるべきこと |
|---|---|
小規模な組織 | 既存のAI利用ガイドラインに判断特化型AI(System One Model)というカテゴリを追加。非機密データでの検証にとどめ、業務判断の自動化組み込みは社内評価後に判断 |
中規模の組織 | APIキーの発行・利用範囲を情シスが把握できる体制を整備。確信度のしきい値を業務部門と共同設計し、SaaS管理ツールで契約・利用状況を可視化 |
大規模な組織 | 対話型AIエージェントと判断特化型AIを前提としたガバナンスフレームワークを整備。監査ログ取得・確信度スコアのモニタリング体制を既存のAIガバナンス施策と統合 |
従業員数が多く複数部門でAIを使う企業では、複数のAIベンダー(対話型のLLM・AIエージェントと、Jevのような判断特化型AI)を前提としたガバナンスフレームワークの中に、この新しいカテゴリを位置づける段階です。監査ログの取得可否や確信度スコアのモニタリング体制を、既存のAIガバナンス施策と統合して検討することをおすすめします。
▶ 関連記事: MCP企業導入のセキュリティ完全ガイド|ガバナンスとリスク対策
よくある質問(FAQ)
Q:JevはChatGPTのようなチャットツールとして使えますか?
A:いいえ。Jevは文章を生成しない設計で、あらかじめ定義した選択肢や評価尺度に沿った構造化データのみを返します。対話用途ではなく、既存の業務システムに組み込んで使う判断コンポーネントとして設計されています。
Q:Jevは本当にハルシネーションを起こしませんか?
A:定義した選択肢やデータ構造から外れた出力が発生しないという意味では「ハルシネーションなし」とされています。ただし、選択肢の中から誤った答えを選んでしまうといった判断そのものの誤りは起こり得るため、確信度スコアと合わせて運用する必要があります。
Q:料金はどのくらいですか?
A:TypeSafe AIは、発表時点の料金として入力100万トークンあたり0.042ドル、出力トークン無料と案内しています。開発元が比較に用いた既存LLMの入力価格は0.20〜10ドル/100万トークンで、これと比べて低コストです。ただし早期アクセス期間中の料金であり、今後変更される可能性があります。
Q:企業の機密データを入力しても安全ですか?
A:TypeSafe AIのプライバシーポリシーでは、入力データをモデルの学習に利用しない方針が明記されています。SOC 2 Type IIレポートは公式エンタープライズページから請求できると案内されています。アクセス制御機能の仕様は公開資料で示されていないため、SSO・RBACが必須の場合はTypeSafe AIにセキュリティ資料の提示を求め、提示がなければ非機密データでの検証にとどめる判断になります。
Q:既存のAI利用ガイドラインの改訂は必要ですか?
A:必要です。Jevのような判断特化型AIは対話型の生成AIツールとは性質が異なるため、確信度のしきい値設計や誤判定時のエスカレーション経路など、既存のガイドラインにない項目を追加で検討することをおすすめします。
まとめ
Jevはチャットボットではなく、業務システムの中で分類や分岐を担う判断用のモデルです。情シスが確認すべき点も、従来の生成AIツールとは異なります。
✅ Jevは対話型ではなく構造化判断特化型のAIサービスであることを、社内の技術者・企画部門に周知する
✅ 確信度のしきい値設計と誤判定時のエスカレーション経路を、導入前に業務部門と合意する
✅ 入力データの学習利用有無・第三者認証の状況を公式資料や問い合わせで確認し、機密データの投入可否を判断する
✅ 既存のAI利用ガイドラインに、判断特化型AI(System One Model)というカテゴリを追加する
✅ APIキーの発行・利用範囲を一元管理し、契約中のAI関連SaaSを可視化できる状態にしておく
Jevのような新しいカテゴリのAIサービスが増えるほど、社内でどのAI関連APIやSaaSが契約・利用されているかを常に把握しておく価値は高まります。把握の手段は、SSOのログ、クレジットカード明細、購買申請台帳の突き合わせでも代替でき、契約数や利用チームが多い組織ほど専用ツールの効果が大きくなります。
【SaaS管理ツールのご紹介】
マネーフォワード AdminaのようなSaaS可視化ツールで契約・利用状況を一元管理しておくと、新しいAIサービスが登場するたびに一から棚卸しをする手間を減らせます。


本記事の内容に誤り等がございましたら、こちらからご連絡ください。
監修
Admina Team
情シス業務に関するお役立ち情報をマネーフォワード Adminaが提供します。
SaaS・アカウント・デバイスの管理を自動化し、IT資産の可視化とセキュリティ統制を実現。
従業員の入退社対応や棚卸し作業の工数を削減し、情報システム部門の運用負荷を大幅に軽減します。
中小企業から大企業まで、情シス・管理部門・経営層のすべてに頼れるIT管理プラットフォームです。