

>
>
公開日
最終更新日
本記事の料金は、2026年7月30日の価格改定後の単価を前提に扱います。
GPT-5.6の現在の位置づけ
OpenAIはGPT-6 SolとGPT-6 Lunaを公開し、2026年9月29日にGPT-6.1 Solも公開しました。GPT-6 SolのAPI料金は100万トークンあたり入力2ドル・出力10ドル、GPT-6 Lunaは入力0.10ドル・出力0.50ドルです。2026年10月23日時点で、GPT-5.6のSol・Terra・LunaはOpenAIの非推奨・提供終了の一覧に載っていません。これから導入するモデルを選ぶ場合は、関連記事「GPT-6 Sol・Luna公開」も参照し、既存業務の継続と新規導入を分けて比較します。

GPT-5.6 Lunaとは|Sol・Terraとの違いと用途
GPT-5.6 Lunaとは、GPT-5.6ファミリーの中で単価を抑え、分類・情報抽出・一次受付など大量の定型処理を想定したモデルです。
短時間で導入可否を判断したい方は、この章の用途比較と「導入時の注意点と失敗パターン」を読めば足ります。単価と長尺入力の差額だけを知りたい方は「料金比較と長尺入力の課金」へ、クラウド経由で使う方は「ChatGPT・Amazon Bedrock・Azureの提供条件」へ進んでください。
本記事のポイント
Lunaは定型処理から試し、複雑な条件整理はTerra・Solと同じ業務データで比較します。
通常API料金は100万トークンあたり入力0.20ドル・出力1.20ドルで、入力272K超ではリクエスト全体の単価が変わります。
ChatGPTの自動利用と画面での直接選択を区別し、モデル固定が必要な処理はAPIで設計します。
本番接続前に予算上限、操作権限、人間の承認、停止・再開の担当者を決めます。
GPT-5.6ファミリーの基本構成
GPT-5.6はSol・Terra・Lunaの3モデルを業務に合わせて比較するシリーズです。
GPT 5.6という表記で探す場合も、申請書や実装設定には接続先とモデルIDを記録します。OpenAIのGPT-5.6 Lunaのモデル仕様に対応するAPI指定はgpt-5.6-lunaです。会話画面に表示する名称と、プログラムから指定する識別子を混ぜると、想定したモデルで試験したかを追えなくなるため、本記事ではChatGPTの会話画面で使うSolを「ChatGPT Sol」(「GPT Sol」「ChatGPT 5.6 Sol」も同じ)、API経由のSolを「GPT-5.6 Sol」(モデルIDはgpt-5.6-sol)と書き分けます。
Sol・Terra・Lunaの用途比較
まずLunaで定型処理を試し、合格率と正常完了1件あたりの費用が基準を満たした業務だけ導入範囲を広げます。
モデル | シリーズ内の位置づけ | 最初に試す業務 | 処理を引き継ぐ条件 |
|---|---|---|---|
GPT-5.6 Luna | 問い合わせ分類、項目抽出、一次受付 | 必須項目の欠落、形式エラー、参照元の不一致 | |
GPT-5.6 Terra | 中間単価のティア | 文書作成、要約、社内文書を参照する回答 | 複数条件の照合や例外判断で業務基準に届かない場合 |
GPT-5.6 Sol | 上位のティア | 複雑な調査、コード設計、専門部門の分析 | 契約判断、本番操作など人間の承認対象に該当する場合 |
この表は用途ごとの実測順位ではなく、社内比較を始めるための設計例です。問い合わせ分類なら、Lunaに部署名と判断根拠を返させ、部署を一つに絞れない案件をTerraへ回します。個別契約に関わる回答は担当者が審査します。全件をSolへ送る方式と比較するときも、API料金と引き継ぎ後の修正時間を同じ範囲で集計します。
情シス・開発担当・利用部門の役割
社内システムへの組み込みでは、情シスが利用条件を管理し、利用部門が業務上の正解を決めます。
開発担当はモデル呼び出し、形式検査、再試行、ログ出力を実装します。情シスは認証、処理地域、予算、停止経路を審査します。利用部門は正解例と保留条件を用意し、回答が業務基準を満たしたかを採点します。回答の文章が読みやすいという理由だけで、本番移行の承認を開発担当へ任せません。
一般提供と利用経路の違い
GPT-5.6の利用開始日は、接続するサービスごとに区別します。
AWSのモデルカードでは、Amazon BedrockにおけるGPT-5.6 Lunaの開始日は2026年7月13日です。Microsoftは、Microsoft Foundryでgpt-5.6-solを2026年7月9日に提供しています。一般提供という案内を読んでも、すべてのプラン、地域、エンドポイントで同じ機能を使えるとは扱いません。
ChatGPT SolとAPI利用の切り分け
ChatGPT Solを社員が使う運用と、APIでGPT-5.6 Solを呼ぶ運用は、請求と障害対応を分けます。
社内で「GPT Sol」と呼ばれていても、利用申請にはChatGPTのワークスペースか、API接続かを記載します。ChatGPT Solを使った手作業の評価結果を、自動バッチの速度や費用へ転用しません。会話履歴を参照した回答と、毎回同じ入力を送るAPI処理では、モデル以外の実行条件も変わるためです。
▶ 関連記事: GPT-6 Sol・Luna公開|API半額の料金・性能と情シスが確認すべき管理設定
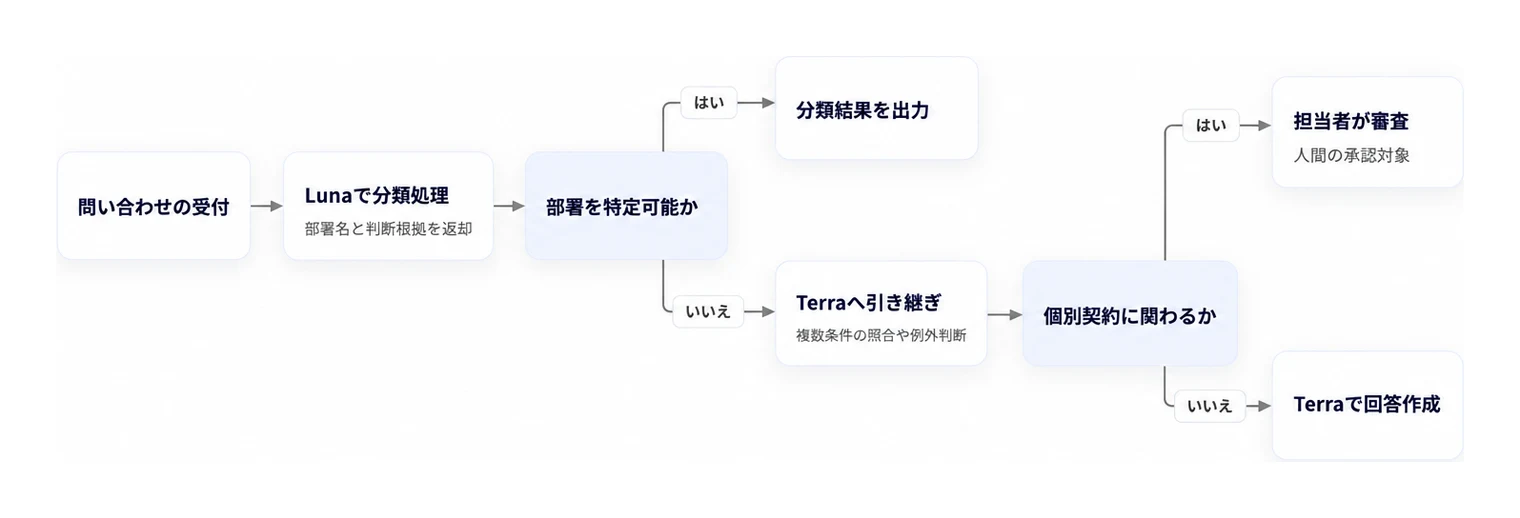
▲ GPT-5.6 Lunaの一次受付からTerraや担当者審査へ引き継ぐ判断の流れ。
Sol・Terra・Lunaの料金比較と長尺入力の課金
予算は価格改定後の単価を使い、入力272K超、キャッシュ、再試行、上位モデルへの引き継ぎを分けて計算します。
2026年7月30日改定後の通常API料金
OpenAI APIのLuna・Terraは、登場時ではなく2026年7月30日の改定後単価で見積もります。
OpenAIはLunaを80%、Terraを20%値下げし、通常API料金を改定しました。以下は100万トークンあたりの米ドル建て料金です。ChatGPTの月額契約、追加ツール費、クラウド事業者経由の請求は含めません。
モデル | 通常入力 | 通常出力 | 試算での扱い |
|---|---|---|---|
GPT-5.6 Luna | $0.20 | $1.20 | 短い定型処理の基準単価 |
GPT-5.6 Terra | $2.00 | $12.00 | 同じ処理量ではLunaの10倍 |
単価が10倍でも、Terraを使ったほうが正常完了までの費用を抑えられる業務は考えられます。例えばLunaの再処理や人手修正が多い業務では、初回料金の差より修正費が大きくなるためです。単価表から業務品質の差を推定せず、同じ正解データで完了費用を測ります。
GPT-5.6 Solの料金と同一課金区分の比較
Sol・Terra・Lunaを一つの表で比較する場合は、3モデルとも同じ料金区分へそろえます。
OpenAIのChatGPT Enterpriseのトークン制料金表は、Enterpriseのトークン制契約に適用される料金で、次の値を掲載しています。これは前の通常API料金表とは課金区分が異なるため、契約見積もりでは別シートへ記録します。同じ料金表では、Solの値はプロモーション料金として掲載され、2026年11月21日より前に終了することはありません。
モデル | 入力/100万トークン | キャッシュ済み入力/100万トークン | 出力/100万トークン |
|---|---|---|---|
GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
GPT-5.6 Terra | $2.00 | $0.20 | $12.00 |
$4.00 | $0.40 | $20.00 |
GPT-5.6 Solの料金を年間予算へ使う際は、契約担当者が標準料金と期間限定条件を分けます。割引の終了日をまたぐ期間は、終了後の費用も算出します。税金、為替、契約上の調整は別項目にし、ドル建て従量料金の増減と混ぜません。
入力272K超に適用される長尺料金
Lunaの入力が272Kを超えると、超過部分ではなくリクエスト全体の入力・出力単価が変わります。
OpenAIのGPT-5.6 Lunaの長尺コンテキスト課金条件では、入力単価は通常の2倍、出力単価は通常の1.5倍です。非キャッシュの通常単価を基準にすると、入力は100万トークンあたり0.40ドル、出力は1.80ドルになります。272Kは約27.2万トークンで、文字数やファイル容量とは別の尺度です。
入力条件 | 入力単価/100万トークン | 出力単価/100万トークン | 適用範囲 |
|---|---|---|---|
272K以下 | $0.20 | $1.20 | 通常料金 |
272K超 | $0.40 | $1.80 | リクエスト全体 |
月間件数から計算する処理費用
月額試算は、平均入力・平均出力・月間件数を固定してから作成します。
月10万件、1件あたり入力2,000トークン・出力300トークンなら、Lunaは入力40ドルと出力36ドルで月76ドルです。Terraで同じトークン量を処理すると月760ドルになります。これは品質を同等と仮定した結果ではなく、処理量だけをそろえた料金計算です。
運用では「月間完了費用=通常処理費+長尺処理費+再試行費+上位モデルへの引き継ぎ費+追加ツール費+人間の修正費」で集計します。正常完了件数で割れば、業務1件を終える費用を比較できます。失敗した呼び出しも費用集計に含め、成功した呼び出しだけで安さを示しません。
プロンプトキャッシュの入力設計
同じ指示を繰り返す処理では、固定部分を先頭へまとめ、実際のキャッシュ適用量から費用を補正します。
出力形式、分類ルール、共通規程は固定し、案件固有の質問や資料を後ろへ置きます。規程を更新したら版番号も変更し、どの規程で回答したかをログへ残します。契約先のキャッシュ条件に合う構成で試験し、命中率100%を前提に予算を減らしません。読み取り料金に加え、利用環境に書き込み料金や保持条件がある場合は、その費用も計上します。
入力分割と検索範囲の判断
長い資料は必要な章を検索して送りますが、判断に必要な関連条項まで切り落としません。
契約書なら本文、別紙、例外条項、定義をひとまとまりで扱う場合があります。章ごとに安く処理できても、統合時の再試行が増えれば総費用は下がりません。検索結果に参照元と周辺条項を付け、それでも前提が不足する案件だけ長尺処理へ送ります。入力を分割した方式と一括方式を同じ正解データで比べ、抽出漏れと完了費用の両方が基準を満たした方式を採用します。
予算台帳には通常入力、長尺入力、キャッシュ読み取りを別列で持たせます。利用額が増えた月でも、単価変更なのか、件数増加なのか、長文案件の増加なのかを切り分けられます。請求書の総額だけで運用を評価すると、改善すべき処理を特定できません。

▲ GPT-5.6ファミリー各モデルの100万トークンあたりの標準API料金比較。
ChatGPT・Amazon Bedrock・Azureの提供条件
利用環境は、直接選択の可否、処理地域、対応機能、請求経路が業務要件に合うかで選びます。
ChatGPT Lunaの自動利用と直接選択
ChatGPT Lunaが会話で使われることと、利用者がLunaを直接選べることは別です。
会話画面の選択欄に出るモデルやデフォルトのモデルはプランや時期によって変わるため、「無料版で使われるなら必ず選択欄に出る」とは判断しません。
無料版・Go・Plus・Business等の社員向け案内は、契約管理者がワークスペースの表示、利用上限、管理者制限を一つの提供条件表へまとめます。特定モデルを固定できる業務はチャット利用で試験し、固定できない業務はモデルIDを指定するAPIへ分けます。画面表示を根拠にバックエンド処理のモデルまで決めることはせず、契約管理者がワークスペースの管理画面とモデル選択メニューで実際の表示を確かめ、プラン名と確認日を提供条件表へ記録します。Lunaが選択欄に出る場合だけチャット利用の試験対象に入れ、出ない場合はAPIで設計します。プラン変更や管理者設定の変更があれば再確認し、結果が変わった業務は試験対象を入れ替えます。
OpenAI APIの機能とモデル指定
モデルを固定して社内処理を実行するなら、OpenAI APIでgpt-5.6-lunaを指定します。
OpenAIのLunaのモデル仕様では、API呼び出し時に指定するモデルIDはgpt-5.6-lunaです。分類だけの処理なら、構造化出力を使い、不要な検索や画面操作は接続しません。
Function callingで返されたツール名と引数は、実行前に社内プログラムで検査します。利用者の権限、操作対象、送信先を照合し、許可した条件に一致したときだけ処理します。モデルが提案した操作を、そのまま実行権限として扱わない実装にします。
Amazon Bedrockの料金とコンテキスト
Amazon BedrockのLunaは、リージョン内推論とグローバルCRISで処理経路と料金を分けます。
AWSのGPT-5.6 Lunaモデルカードでは、コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークンです。商用リージョンの入力272K以下に対する料金は次のとおりで、グローバルCRISは入力0.20ドル・キャッシュ読み取り0.02ドル・出力1.20ドル、Geo CRISはリージョン内推論と同額です。OpenAI APIと同じ値でも、Bedrockの見積もりには同モデルカードに載る経路別の単価と272K超の長尺料金を使います。
提供経路 | 入力/100万トークン | キャッシュ読み取り/100万トークン | 出力/100万トークン |
|---|---|---|---|
リージョン内推論 | $0.22 | $0.022 | $1.32 |
処理地域を限定する契約では、単価より先に推論経路を絞ります。地域要件を満たす経路を確保できればクラウド内で試験し、満たさなければ対象データを送信せず、別の経路か有人処理へ戻します。システム全体をAWSで構成していても、モデルの推論先まで同じ条件とは決めつけません。
Bedrockの対応機能と移植条件
bedrock-runtimeへ移す場合は、サーバー側のツール使用とトークンカウントをアプリケーション側で補います。
同モデルカードに掲載する対応機能は、呼び出しログ、レスポンスストリーミング、不正検出、Converse APIでのガードレール、暗黙的・明示的プロンプトキャッシュ、構造化出力です。サーバー側のツール使用とトークンカウントは非対応です。OpenAI API向けコードを移植するときは、モデル呼び出しとツール実行を分離し、入力上限を呼び出し前に判定します。
ファイルを読み込んだ後に本文や検索結果が追加される実装では、ファイル単体のサイズ制限だけでは不足します。システム指示、会話履歴、ツール定義も含めた入力全体へ上限を設けます。上限を超えた案件は黙って切り詰めず、再検索か担当者の審査へ送ります。
Azure・Microsoft Foundryのデプロイ条件
AzureでLunaを調達する場合は、Microsoft Foundryに掲載されたgpt-5.6-lunaの仕様と、対象デプロイの条件で申請します。
MicrosoftのMicrosoft Foundryの直接販売モデル一覧では、gpt-5.6-sol・gpt-5.6-terra・gpt-5.6-luna(いずれも2026年7月9日版)のコンテキストウィンドウは1,050,000トークン、最大入力は922,000トークン、最大出力は128,000トークンです。
AzureのLunaの単価はAzure OpenAIの料金ページに掲載されています。契約単価は、Microsoftの担当窓口やAzureサポート要求の作成手順で照会した回答を調達票に転記し、OpenAI APIの入力0.20ドルをAzureの請求単価として申請しません。調達票にはモデルID、デプロイ方式、リージョン、クォータ、入力上限、出力上限、契約単価を記載します。必要な地域と容量を確保できればAzureで比較試験へ進み、確保できなければ別経路での試験とデータ審査を組み直します。
提供環境を比較する調達票
調達担当と開発担当は、同じ比較票でサービスごとの条件差を管理します。
項目 | ChatGPT | OpenAI API | Amazon Bedrock・Azure |
|---|---|---|---|
主な実行主体 | 会話画面を使う社員 | 社内アプリケーション | クラウド上のアプリケーション |
モデル管理 | 表示・自動利用・管理設定を区別 | モデルIDを設定管理 | モデルIDとデプロイ先を管理 |
費用管理 | 契約プランの利用枠 | APIの従量課金 | クラウド契約と推論経路別の課金 |
導入判定 | 対象作業を再現できるか | 出力・権限・予算を制御できるか | 地域・容量・機能条件を満たすか |
同じGPT-5.6 Lunaでも、エンドポイントが変われば試験をやり直します。請求先の変更だけでなく、ログ項目、エラー処理、ストリーミングの終了判定も比較し、運用担当が障害を追跡できる状態で切り替えます。
GPT-5.6シリーズの性能比較と競合LLMとの違い
GPT-5.6 Lunaの性能は、コンテキスト容量、業務合格率、待ち時間、正常完了費用を分けて評価します。
Lunaのコンテキスト上限と出力仕様
OpenAI APIのLunaは、105万トークンのコンテキストと最大12.8万トークンの出力に対応します。
OpenAIのLunaの技術仕様では、コンテキストウィンドウは1,050,000トークン、最大出力は128,000トークンです。入力に容量を使い切らず、出力と実行時に必要な情報の分を見込んで入力予算を設定します。大量の資料を送れる性能と、必要な条件を漏れなく拾う性能は別々に試験します。
長文処理の正確さと保留判定
長文評価では、正解を答える案件と、情報不足で保留する案件を同じ試験に含めます。
契約審査の補助なら、本文、別紙、例外条項、用語の定義を含む正解データを作成します。採点対象は回答の自然さではなく、文書ID、条番号、適用条件、結論の一致です。必要な情報がない資料も混ぜ、根拠を補って回答しないかを調べます。参照した箇所が正しくても、別紙の優先条件を落とした回答は不合格にします。
コーディング系ベンチマークの測定条件
コーディング系ベンチマークは、推論設定、ツール、時間制限、試行回数をそろえて読みます。
コーディング系の比較では、モデル名だけでは実行条件を特定できないため、推論設定や追加設定を分けて記録します。テスト実行が可能な環境と、コードを返すだけの環境では完了条件が変わります。異なる条件の得点を並べて、問い合わせ分類や文書抽出の精度へ換算しません。
SolとLunaの公開評価・導入実績
V7の公開事例では、Solのツール呼び出しとLunaの文書処理費用で異なる改善を測っています。
OpenAIが公開したV7のContext GraphベンチマークとV7 Goの導入事例では、GPT-5.6 Solのツール呼び出しエラー率がGPT-5.5の2.7%から0.2%へ低下しました。V7 Goの文書処理では、GPT-5.6 Lunaの文書1件あたりの処理コストがGPT-5.4 mini比で78%低下しています。
自社試験では通常文書と例外文書を分け、抽出漏れ、再処理回数、担当者の修正時間を残します。モデルを切り替えた効果と、文書形式や処理手順を変えた効果が混ざらないようにします。
競合LLMと統一する評価軸
AnthropicやGoogleの競合LLMにも同じ評価票を使い、必須条件を満たした候補だけ費用比較へ進めます。
評価軸 | 測定値 | 固定する条件 | 不合格とする例 |
|---|---|---|---|
正確さ | 業務合格率、抽出漏れ、根拠一致率 | 入力資料、正解、採点基準 | 必須項目の欠落や存在しない根拠 |
速度 | 最初の応答時間、完了時間、時間内完了件数 | 出力長、同時実行数、測定区間 | 期限内に完了しない案件の滞留 |
費用 | 正常完了1件あたりの総費用 | 再試行、引き継ぎ、人手修正の範囲 | 安い初回料金に対して修正費が増加 |
操作 | 正しいツール・引数・対象を選ぶ割合 | ツール定義、権限、戻り値 | 別の顧客やレコードへの更新 |
運用 | 監査できる実行範囲 | ログ、処理地域、保持期間 | 承認や実行結果を追跡できない処理 |
総合点へ足し合わせる前に、業務の必須条件で候補を絞ります。コード生成ならテスト合格、文書抽出なら項目一致、社内検索なら根拠と閲覧権限を独立した合格条件にします。安い料金や速い応答で、権限外文書の混入を相殺する評価にはしません。
推論設定と出力形式の比較条件
推論設定や出力上限を変えたら、何を変えたかを評価票に1項目ずつ残します。
推論の強さ、出力上限、プロンプト、検索件数を同時に変えると、改善の原因が分かりません。まず同じ指示と資料で比較し、その後にモデルごとの設定調整を別試験として実行します。構造化出力を使う処理では、JSONとして読めた割合と、値が業務上正しかった割合を分けます。形式に合う誤回答を成功扱いしない採点にします。
モデル振り分けと全体合格率
Lunaから上位モデルへ回す条件は、モデルの自己評価ではなく、入力条件と出力検査で定義します。
必須キーの欠落、定義外カテゴリ、参照元の不一致を検知したら再処理し、再試行でも合格しなければTerraまたはSolへ引き継ぎます。個別契約や人への不利益につながる案件は、最初から担当者の審査へ送ります。転送率が上がった場合は、入力欠落、規程変更、検索結果の変化を順に調べます。
最終的にはモデル単体の合格率と、振り分け全体の正常完了率を併記します。Lunaの初回合格率が高くても、残りの例外処理が長時間滞留するなら業務は完了しません。処理期限、例外キュー、人間の対応時間まで含めて運用範囲を決めます。
高速処理の活用とトークン消費の上限設定
高速処理を本番で使う前に、情シスは入力・出力・同時実行・反復回数の上限と予算超過時の遮断を実装します。
Lunaの低遅延処理と速度指標
Lunaを分類や一次受付へ使う場合は、生成速度より業務の待ち時間と時間内完了件数を測ります。
TPSは1秒あたりに生成するトークン数で、入力送信から処理完了までの時間とは異なります。問い合わせ窓口なら、待ち行列に入ってからカテゴリが確定するまでを計測します。夜間の文書処理なら、実行可能な時間内の正常完了件数を測ります。同時実行数を増やす試験と、1件の応答を短くする試験は別々に走らせます。
SolのFastモードと追加料金
SolのFastモードは、短縮した待ち時間に追加料金を払う業務へ限定して比較します。
OpenAIのGPT-5.6の価格・性能に関する発表では、SolのFastモードはStandardの2倍の料金で最大2.5倍の処理速度を提供します。この倍率をLunaや別クラウドの速度として使いません。担当者が応答を待って作業を再開する業務と、翌朝までに終わればよいバッチ処理では、支払う理由が変わります。
短時間の大量実行と予算監視
処理速度が上がるほど、月次集計だけでは異常な支出を止められなくなります。
高速化したジョブは、誤った入力や再試行も短時間に処理します。運用担当は実行件数、失敗件数、トークン数、残予算を同じ時間軸で監視します。件数増加による支出か、再試行の連鎖かを判別できれば、異常なジョブだけ停止できます。非緊急バッチを止めても、一次受付と有人窓口は残せる構成にします。
入力・出力・反復上限の設定手順
本番用の認証情報を発行する前に、開発担当が業務別の制限値を設定します。
入力上限を決めます。システム指示、履歴、資料、ツール定義を含む入力全体を計測し、通常処理と長尺処理を分けます。
出力上限を決めます。分類、要約、コード生成で必要な長さを分け、APIの最大出力設定へ反映します。
反復上限を決めます。再試行、ツール呼び出し、子エージェント生成を別々に数え、同じエラーが続けば停止します。
同時実行数を制限します。待ち行列を設け、急な件数増加を全件同時実行へ直結させません。
予算到達時に遮断します。日次・月次の使用量を集計し、上限到達後は新規ジョブを受け付けません。
停止と再開を試験します。上限到達を模擬し、実行中ジョブ、通知先、再開承認者の動作を検証します。
Spend LimitやMax Completion Tokensという設定名だけで、全環境に同じ制御があるとは判断しません。通知のみの予算機能なら、社内ゲートウェイが実行を遮断します。出力上限でJSONが途中切れした場合は、成功として保存せず、形式エラーへ分類します。
設定値の決定と負荷試験の範囲
上限値はモデルの最大仕様ではなく、対象業務の代表データと処理期限から決めます。
分類に短いカテゴリ名しか要らないなら、長文の説明を生成させません。要約で必要な項目が多いなら、項目ごとの文字数と必須キーを定義します。負荷試験では、通常入力、長文入力、ツール応答遅延、形式エラーを混ぜ、処理数が増えても停止条件が働くかを調べます。最大性能だけを測る試験と、制限下で業務を完了する試験を分けます。
定型案件と例外案件の待ち行列
緊急度の違う案件は待ち行列を分け、夜間バッチが一次受付を圧迫しないようにします。
一次受付ではカテゴリ、緊急度、担当候補を短い構造化データで返します。複数部署に該当する案件、契約確認が必要な案件、情報不足の案件は例外キューへ送ります。担当者の画面では保留理由と入力資料を一緒に表示し、最初から読み直す負担を減らします。例外案件の完了期限も決め、モデルの応答速度だけで窓口全体の速さを評価しません。
再試行の対象と停止条件
再試行は一時的な障害へ限定し、権限不足や入力不備では同じ呼び出しを繰り返しません。
一時的な接続失敗なら間隔を空けて再実行し、上限回数に達したら運用担当へ通知します。必須資料がない案件は利用部門へ差し戻し、権限不足はアクセス管理の窓口へ送ります。原因別に処理先を分けると、モデルを上位へ変えても解消しない失敗へ料金を使わずに済みます。

導入時の注意点と失敗パターン
本番接続では、誤回答そのものに加えて、過剰実行、権限外参照、二重更新を止める仕組みを先に用意します。
低単価を前提にした過剰実行
Lunaの単価が低くても、再試行と長文出力を無制限にすると利用額を制御できません。
失敗パターン | 発生する問題 | 本番前の対策 |
|---|---|---|
同じエラーの反復 | 入力や権限が原因でも呼び出しが続きます | エラー種別と連続回数で停止します |
資料の一括入力 | 不要な章で長尺料金と待ち時間が増えます | 必要な章と関連条項を送ります |
曖昧な終了条件 | 回答後も調査やツール操作が続きます | 必須項目と終了条件をプログラムで判定します |
シャドー・エージェント | 管理外のIDと接続先が増えます | 作成者、数、権限、失効日を台帳へ登録します |
完了報告だけの保存 | 回答と実際の更新結果を照合できません | ツール実行と承認の記録を保存します |
サービスIDと認証情報の増加
AI用の認証情報には、所有者、用途、権限、失効日をひも付けます。
IPAの2026年9月のAIセキュリティ関連資料は、Netwrix Research Labが2026年初めに2,317人の専門家・1,889組織を対象に実施した調査を紹介しています。AI導入でID数が大幅に増えた組織の過去12カ月の侵害率は43%で、影響していない組織は11%でした。これは組織群の差であり、AI導入が侵害を引き起こしたと示す因果関係ではありません。
本番ジョブには開発担当者の個人アカウントを流用せず、読み取り専用のサービスIDから始めます。利用終了後の失効担当者も発行時に決めます。担当変更や退職があっても業務責任者を追える単位で管理し、子エージェントが新しい認証情報を自由に作れない設計にします。
外部文書の指示と操作権限の混同
外部文書に書かれた命令で、接続先や送信先を変更させません。
メール、Webページ、添付文書には、AIへの命令に見える文章が混在する場合があります。処理対象の情報として読み取っても、権限を与える指示として扱いません。接続先、送信先、実行可能な操作は社内プログラムの設定から取得します。請求先や送金先の変更を、文書内の指示だけで確定しない処理にします。
重要操作の承認と実行結果の照合
本番DB更新、決済、削除、権限変更、顧客向け送信は、初期導入では人間の承認を挟みます。
承認画面には変更対象、変更前後の値、参照資料を表示します。承認した対象と実行対象を照合し、実行直前に別のレコードへ変わっていないかを検査します。取り消せる操作には復旧手順を用意し、取り消せない操作は承認条件を厳しくします。承認ボタンの記録だけでなく、ツール側の成功・失敗も実行IDへひも付けます。
再実行による二重更新
障害後の再実行では、更新済みの案件を同じ処理へ戻しません。
ジョブごとに実行IDを付け、外部更新の前後で状態を保存します。応答が途切れた場合は、モデルの完了報告より先に更新先の状態を調べます。更新済みなら結果の回収へ進み、未更新なら失敗した処理だけを再開します。別モデルへの切り替えでも実行IDを引き継ぎ、同じ注文や通知が重複しないようにします。
安全性評価と自社業務の承認条件
安全性評価の応諾率を、自社システムの安全稼働率や攻撃成功率へ読み替えません。
IPAの2026年9月28日のAIセキュリティ関連資料は、GPT-5.6-CyberとDaybreak Blue・Daybreak Redを扱っています。特定の要求に応じるOpenAIの社内評価では、GPT-5.6-Cyberの応諾率は95.0%、GPT-5.6 Solは1.5%、Daybreak Blue経由のSolは2.0%です。GPT-5.6-CyberはDaybreak Redを通じて提供されます。
自社の承認試験では、許可していない操作の拒否、機密情報の出力防止、停止後のツール遮断を別々に試します。回答文だけを審査せず、外部送信とファイル変更の記録も対象にします。モデルに安全機能があっても、社内の権限判定と承認処理はアプリケーション側へ残します。
機密情報とログ保存の範囲
監査ログは必要な項目へ絞り、入力本文を無制限に保存しません。
通常の記録は文書ID、モデルID、トークン数、操作先、承認者、実行結果にします。本文を保存する業務だけ、保存目的、閲覧者、削除期限を定義します。障害解析で使うログを検証環境へ渡す場合は、個人情報や認証情報を除きます。証跡を増やした結果、ログ保管先が機密情報の集積場所にならない運用にします。
企業事例から見る導入効果と管理設定
企業事例は、対象業務、実施時期、施策、成果の範囲を確認し、自社の検証条件と一致する部分だけを参考にします。
V7 Goの文書処理コスト削減
V7 Goでは、文書処理にLunaを使った際の1件あたりの処理コストが比較指標になります。
OpenAIが2026年に公開したV7 GoのGPT-5.6導入事例では、GPT-5.6 Lunaの文書1件あたりの処理コストがGPT-5.4 mini比で78%低下しました。業種・対象は文書処理サービス、測定単位は文書1件です。文書処理の費用を抑える施策としてLunaを利用した結果であり、企業全体のAI費用や人件費を78%減らしたという数値ではありません。
V7のツール呼び出し改善
V7のSol評価は、文書処理の費用とは別に、ツールを正しく呼ぶ性能を測っています。
同公開事例のContext Graphベンチマークでは、GPT-5.5のツール呼び出しエラー率2.7%に対し、GPT-5.6 Solは0.2%でした。対象はツール呼び出しで、Lunaの抽出精度を示す値ではありません。自社で再現する場合は、利用するツール定義と許可する引数を固定し、正しい回答でも別のレコードを更新した案件は不合格にします。
シフトプラス「自治体AI zevo」の管理者許可
シフトプラスの自治体AI zevoは、新モデルを管理者が許可してから開放する運用例です。
シフトプラスの自治体AI zevoのGPT-5.6対応発表では、2026年の対応時にsol・terra・lunaの3モデルを初期状態で「利用禁止」とし、組織管理者の許可設定を必要としています。同発表におけるgpt-5.6-solの仕様は入力920K・出力128K、提供リージョンはEUです。これは自治体向けサービス内の提供条件で、すべてのGPT-5.6環境へ共通する条件ではありません。
国内事例を自社へ適用する条件
新モデル追加時に地域や契約の再審査がある組織では、zevoと同様に初期状態を利用禁止へそろえます。
業務責任者が利用目的を申請し、情シスが処理地域と情報区分を審査した後、管理者が対象部署へ開放します。既存モデルを利用できる社員にも新モデルを自動許可せず、許可日、対象業務、承認者を記録します。利用者数の増減ではなく、許可した範囲を越えるデータ送信や操作が起きていないかを運用レビューで調べます。
事例を比較する共通フォーマット
社内提案では、費用削減の事例と利用統制の事例を同じ成果として混ぜません。
企業・サービス | 業種・対象規模 | 時期 | 課題と施策 | 成果・運用範囲 |
|---|---|---|---|---|
V7/V7 Go | 文書処理サービス/文書単位 | 2026年公開事例 | 文書処理の費用を抑えるためLunaを利用 | GPT-5.4 mini比で1件あたり78%のコスト低下 |
V7/Context Graph | ツール利用の評価/呼び出し単位 | 2026年公開事例 | GPT-5.5とGPT-5.6 Solの呼び出しを比較 | エラー率2.7%から0.2%へ低下 |
シフトプラス/自治体AI zevo | 自治体向けAIサービス/組織管理単位 | 2026年のGPT-5.6対応 | 追加モデルを管理者許可制で提供 | 3モデルを初期状態で利用禁止 |
自社で追加する測定項目
導入効果を報告するなら、処理件数と修正時間をモデル利用料へ添えます。
文書の種類、平均ページ数、抽出項目、再処理の扱いを試験前に固定します。利用部門は抽出漏れと修正時間を採点し、情シスはトークン数、実行時間、処理地域を記録します。作業時間を測っていない段階では、トークン削減を人件費削減へ換算しません。定型文書と例外文書を分けて報告すれば、どこまでをLunaで処理できるかを説明できます。
比較の途中で入力文書や抽出項目を変えた場合は、変更前後を別の集計へ分けます。費用の差がモデル変更によるものか、対象業務を狭めたためかを追えるようにします。改善率を一つ示すより、正常完了件数と例外処理の残件数を併記したほうが、本番で必要な人員と予算を決めやすくなります。
情シス向けの導入チェックリストと切り替え設計
情シスは一つの定型業務で限定検証を行い、業務合格率と停止試験を満たした範囲から利用を広げます。
入力情報と操作に応じた初期範囲
統制の強さは従業員数ではなく、入力する情報と実行する操作で決めます。
対象業務 | 初期の実行範囲 | 利用開始前の実装 | 範囲を広げる条件 |
|---|---|---|---|
公開情報の分類 | Lunaで分類結果を返します | 出力形式の検査と誤分類の採点 | 代表データで合格基準を満たします |
社内文書の検索・要約 | 閲覧権限のある文書だけ参照します | 権限連携と文書IDの記録 | 権限外文書が混入しない試験に合格します |
個人情報を含む処理 | 必要な項目だけ入力します | 契約、地域、保持期間の審査 | 責任者が対象データの扱いを承認します |
外部システムへの書き込み | 変更案だけ返します | 人間の承認と復旧処理 | 承認内容と実行内容を照合できます |
少人数の利用でも本番環境を操作するなら、権限制御と監査記録を先に実装します。公開情報の分類だけなら、検証段階で社内サービスへの接続を増やしません。利用目的に不要な連携を外すと、失敗時に調べる範囲も小さくできます。
30日間の限定検証計画
次の計画例では、業務責任者、開発担当、情シス、運用担当の作業を期間ごとに分けます。
期間 | 担当 | 実施内容 | 次へ進む条件 |
|---|---|---|---|
1〜5日目 | 業務責任者・情シス | 対象業務、正解例、入力禁止情報を定義 | 採点できる代表データを用意 |
6〜10日目 | 開発担当・利用部門 | Luna・Terra・Solを同じデータで比較 | 合格率、完了時間、費用を記録 |
11〜15日目 | 情シス・開発担当 | 認証、各種上限、ログ保存を実装 | 上限到達時に実行を停止 |
16〜20日目 | 利用部門・運用担当 | 例外案件、障害、有人引き継ぎを試験 | 誤回答と障害の対応先を特定 |
21〜30日目 | 業務責任者・運用担当 | 合格用途を承認し定期レビューを開始 | 利用範囲と停止・再開担当を確定 |
これは導入期間の保証ではなく、作業を割り当てる計画例です。正解データを用意できない業務は、モデル比較より先に現在の判断手順を整理します。採点基準を決めないまま全社へ開放すると、文章の好みと業務上の誤りを区別できません。
合格基準と評価データの作成
利用部門は代表案件に加え、例外、情報不足、権限外の案件を評価データへ含めます。
分類なら正しいカテゴリ、抽出なら必須項目と値、要約なら残すべき条件を定義します。回答を保留すべき案件にも正解を付けます。開発担当は正解とは別に、形式エラー、タイムアウト、ツール失敗を記録します。業務上の不合格とシステム障害を分ければ、プロンプト修正と運用修正の担当を割り振れます。
モデル変更時の差分管理
モデル、プロンプト、参照資料を変えるたびに、固定した評価データを再実行します。
評価票には実行日、モデルID、提供環境、プロンプトと資料の版、設定値、合否を残します。正解を変更した場合は理由も記録し、モデルの改善と採点基準の変更を分けます。本番の誤回答を追加するときは、判断条件を残して個人情報を匿名化します。利用部門が正解を管理し、情シスが実行条件を管理する役割分担にします。
APIゲートウェイと代替モデル
サービス停止へ備える場合は、モデル切り替え、権限判定、ログ保存を別の仕組みに分けます。
社内APIゲートウェイで入出力の形式をそろえ、OpenAI、Anthropic、Google、国内またはオンプレミスのモデルへ接続する経路を分けます。代替先にも代表タスクを実行し、使えないツール機能がある業務は有人処理へ戻します。同じ提供元の別モデルと、別基盤への接続では障害時の独立性が異なるため、認証、ネットワーク、予算も分けて試験します。
障害時の切り替え判定
切り替えは応答の有無だけで決めず、失敗した処理の種類と更新状態から判定します。
一時的な接続障害なら、上限内で再試行します。
提供停止や継続的な障害なら、承認済みの代替経路へ送ります。
権限や処理地域の条件を満たさない場合は、代替モデルへ自動送信しません。
更新済みか判定できない案件は保留し、運用担当が状態を照合します。
切り替え後は同じ実行IDを使い、処理済みの案件を除外します。代替先で出力形式が変わる場合は、変換処理の検査を通してから保存します。正常系の切り替えだけでなく、切り替え先も使えない場合の有人窓口まで試験します。
独立した監査ログと保管先
監査ログは、AIが書き換えられない保管先へ実行ID付きで送ります。
ログには使用モデル、入力資料の識別子、操作先、承認者、実行結果をひも付けます。モデルの回答とツールの実行記録を別々に保存し、後から照合します。運用担当には障害調査に必要な閲覧権限を与え、ログ削除の権限は分離します。保管期間が終わった記録を削除する処理も、モデルの操作権限から外します。
本番移行前のチェックリスト
次の項目を満たした業務だけ、本番用の接続先へ切り替えます。
モデルID、提供環境、処理地域、契約単価を台帳へ登録しています。
業務責任者が判定できる合格基準と正解例を用意しています。
通常入力、長尺入力、再試行、引き継ぎを見積もりに含めています。
認証情報を社員へ直接配らず、業務単位で権限を限定しています。
文書の閲覧権限を検索処理へ引き継いでいます。
形式エラーと業務上の誤りを分けて検知できます。
予算到達時に新規実行を停止できます。
有人窓口、代替モデル、再開承認者を決めています。
運用開始後のレビューと拡大条件
利用範囲を広げる前に、業務責任者と運用担当が同じ期間の品質・費用・滞留を読み合わせます。
業務責任者は誤りの種類、運用担当は失敗と再試行、情シスは利用量と権限変更を報告します。合格率が維持できても例外キューが増えているなら、担当者の処理能力に合わせて受付量を調整します。新しい文書形式や新部署を追加するときは、既存の合格率へ混ぜず、追加範囲を個別に評価します。
料金やモデルの変更があっても、名称だけで一括切り替えません。代表データの再試験と費用試算を終えてから対象範囲を更新します。既存業務を継続する担当と、新しい候補を検証する担当を分ければ、日常運用を止めずに比較を進められます。
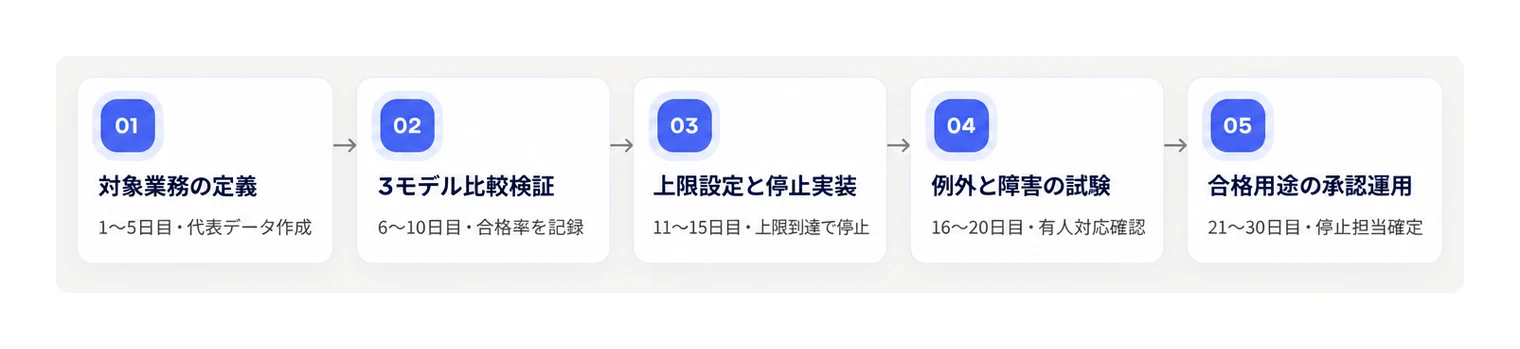
▲ 情シスと利用部門が連携して進める30日間の限定検証計画。
よくある質問
GPT-5.6 Lunaの導入判断では、ChatGPTの選択方法、API上限、課金経路を分けると利用条件を読み違えずに済みます。
Q:ChatGPT上でLunaを直接選択できるか
ChatGPTの会話画面でLunaを直接選べるかはプランや管理者設定で変わるため、契約管理者がモデル選択メニューで実際の表示を確かめます。選択欄に出ない場合や特定モデルの固定が必要な業務は、APIで設計します。
Q:Lunaのコンテキスト上限と改定後の料金はいくらか
OpenAIのLunaの仕様では、コンテキストは105万トークン、最大出力は12.8万トークンです。OpenAIが公表した改定後の通常API料金は100万トークンあたり入力0.20ドル・出力1.20ドルで、入力272K超ではリクエスト全体の入力が2倍、出力が1.5倍になります。
Q:SolとLunaの使い分け基準は何か
分類・抽出・一次受付はLunaで試し、複雑な推論やコード設計で合格基準に届かない案件はSolと比較します。単価の差ではなく、再試行と人間の修正を含む正常完了1件あたりの費用で処理範囲を決めます。
Q:Amazon Bedrockでも同じ機能を使えるか
機能構成は同じではなく、AWSのLunaモデルカードではbedrock-runtimeのサーバー側ツール使用とトークンカウントは非対応です。既存アプリケーションを移す場合は、ツール実行と入力上限の管理をアプリケーション側で補ってから切り替えます。
Q:GPT-6 Solの公開後もGPT-5.6を利用できるか
2026年10月23日時点で、GPT-5.6のSol・Terra・LunaはOpenAIの非推奨・提供終了の一覧に載っていません。既存業務は利用環境の提供条件に沿って継続し、新規導入ではGPT-6 Sol・Lunaも同じ業務データで比較します。
Q:Lunaの単価が低ければ全件を任せてよいか
全件を自動処理へ送らず、必須項目の検査と保留条件を実装してから利用範囲を広げます。契約判断、決済、削除、権限変更などの重要操作は、人間の承認と実行結果の照合を残します。
まとめ
GPT-5.6 Lunaは、分類・抽出・一次受付を低単価で処理する候補です。導入時は通常料金に長尺入力、再試行、上位モデルへの引き継ぎ、人間の修正費を加え、正常完了1件あたりで比較します。
明日から始めるなら、一つの業務の代表データと正解例を用意し、Luna・Terra・Solを同じ条件で試します。出力検査、予算遮断、操作承認、停止担当まで実装してから本番へ進みます。新規導入の選定ではGPT-6 Sol・Lunaも比較対象に含め、既存業務の継続とは分けて判断します。


本記事の内容に誤り等がございましたら、こちらからご連絡ください。
監修
Admina Team
情シス業務に関するお役立ち情報をマネーフォワード Adminaが提供します。
SaaS・アカウント・デバイスの管理を自動化し、IT資産の可視化とセキュリティ統制を実現。
従業員の入退社対応や棚卸し作業の工数を削減し、情報システム部門の運用負荷を大幅に軽減します。
中小企業から大企業まで、情シス・管理部門・経営層のすべてに頼れるIT管理プラットフォームです。





