
>
>
公開日
最終更新日
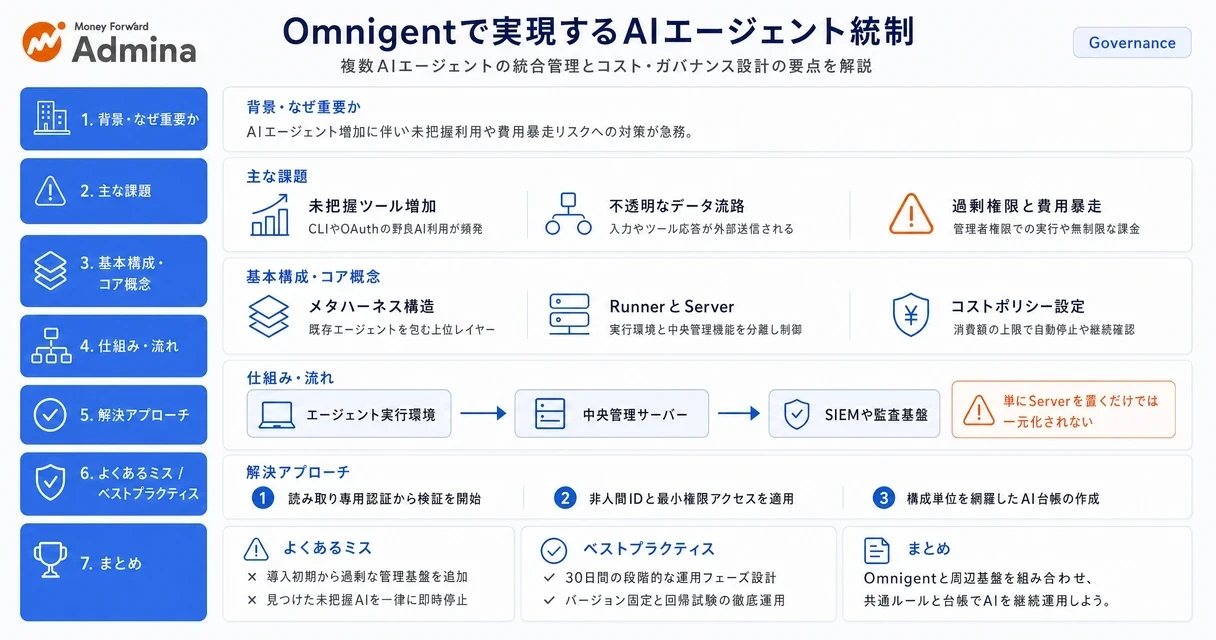
AIエージェントの企業利用では、回答文を生成するだけでなく、コード編集、ファイル操作、データ検索、API呼び出しまで自律的に実行するケースが増えています。このとき情シス部門が管理すべき対象は、利用中の生成AIサービスだけではありません。誰が起動したか、どのエージェントがどの認証情報を使ったか、どのデータへ接続したか、どの操作を実行したか、いくら使ったか、停止できるかまでを一続きで把握する必要があります。
Omnigentは、複数のAIエージェントを切り替え、共有し、共通ポリシーで制御するためのオープンソースのメタハーネスです。Databricks Omnigentを検討する担当者向けに、公式情報で確認できる仕様と、企業導入時に別途設計すべき統制を分けて解説します。個人開発の便利なCLIとしてではなく、複数のコーディングエージェントが併存する組織のAIエージェントガバナンス基盤として評価する視点が重要です。
Omnigentとは?複数AIエージェントを統合するOSS
Omnigentとは、複数のAIエージェントを共通の実行・統制レイヤーで扱う、Databricks発のオープンソースのメタハーネスです。
本記事のポイント
Omnigentは、Claude Code、Codex、Cursor、Pi、自作エージェントなど複数のエージェントへの対応が案内されています。ただし、対応状況はバージョンによって変わる可能性があるため、採用時点の対応エージェント一覧は公式GitHubリポジトリ(omnigent-ai/omnigent)のREADMEで確認し、目的のエージェントが記載されていれば検証環境での動作確認へ進んでください。
基本構造は、エージェントをラップして実行するRunnerと、任意で接続する中央管理機能のServerです。
Omnigentでは、設定した費用閾値に達したエージェントを一時停止し、継続確認を求めるようなコストポリシーを組み合わせられると、Databricks公式ブログで紹介されています(出典:Databricks公式ブログ「Introducing Omnigent」)。ただし、本記事公開時点で公式ドキュメントから「100ドル」という閾値の記述を直接確認できていないため、採用する場合は公式リポジトリおよびドキュメントで現在の仕様を確認したうえで閾値を設定してください。
本番利用では、Omnigentだけに依存せず、ID管理、秘密情報管理、データ権限、監査ログ、SIEMを組み合わせて統制します。
定義と開発主体
Omnigentは、既存のエージェントを新しいエージェントに置き換える製品ではありません。個別のエージェントハーネスを包み、同じセッションやポリシーの下で使い分けるための上位レイヤーです。Databricksは、Claude Code、Codex、Pi、カスタムエージェントに対応する統合インターフェースとしてOmnigentを案内しています。
Omnigentは、Databricksがオープンソースとして公開したメタハーネスです(公式ブログの著者はMatei Zaharia氏とKasey Uhlenhuth氏)。ソースコードはApache License 2.0で公開されているため、ライセンス条件の範囲で検証環境への導入や自社運用を検討できます。一方で、OSSであることは企業要件を自動的に満たすことを意味しません。脆弱性対応、バージョン固定、ログ保管、障害対応、秘密情報の管理責任は導入側に残ります。
対象読者と適用範囲
Omnigentの検討対象は、開発部門やDX部門で複数のAIエージェントが使われ、ツール別の設定や費用管理が分散している企業です。Claude Codeのみを少人数で限定利用し、外部システムへの書き込みも行わない場合は、最初からメタハーネスを追加すると運用対象だけが増えることがあります。
一方で、複数のコーディングエージェント、自作の業務エージェント、複数のモデルプロバイダーが併存し、社内リポジトリ、クラウド、データベース、チケット管理などへ接続する場合は、統制の置き場を共通化する価値があります。評価の出発点はエージェント数ではなく、外部送信、データ更新、認証情報利用、クラウド資源作成、従量課金API利用の有無です。
正式名称と類似表記
正式名称はOmnigentです。検索ではOminigent、OmniAgent、Omnigen、OmniGent、Databricks Omniagentといった表記が見られますが、社内台帳、運用手順書、ソースコードの依存関係、脆弱性情報の検索ではOmnigentに統一します。類似表記を台帳に残すと、更新情報や障害情報を別製品のものと取り違える原因になります。
Databricksが公開したOmnigentは、マイナビニュース(2026年6月18日付)でオープンソース化が報じられたメタハーネスです(出典:マイナビニュース 2026年6月18日付)。オープンソース化の時期や経緯については公式リポジトリの変更履歴で確認してください。仕様はバージョンにより変更される可能性があるため、導入前に採用バージョンを固定します。BCC Researchは、AIエージェント市場が2030年に483億ドル規模に達するという予測を発表しています(出典:BCC Research プレスリリース。調査対象範囲・前提条件・成長率の算出方法は同資料を参照してください)。市場の成長予測そのものを導入根拠にするのではなく、自社で利用中のエージェント、接続先、費用、権限を可視化したうえで、統制レイヤーが必要かを判断します。
メタハーネスの構造と既存エージェント基盤との違い
Omnigentは、個別エージェントを作るフレームワークではなく、既存エージェントを横断して実行・共有・統制するためのメタハーネスです。
RunnerとServerの役割
Omnigentの基本構造はRunnerとServerで構成されます。RunnerはClaude CodeやCodexなどのエージェントをラップし、利用者の端末や実行環境でセッションを動かす役割を持ちます。Serverは任意で接続する中央管理機能で、複数のRunnerや共有セッションを扱うための基盤です。
この分離により、現場の開発者はRunnerを通じて使い慣れたエージェントを利用しながら、組織側はServer(Omnigent標準機能)や、認証基盤・監査ログ・SIEMといった導入側で追加実装する周辺基盤を組み合わせて、共有、ポリシー、観測を設計できます。ただし、Serverを置いたからといって、すべての認証情報、データ権限、監査証跡が自動的に一元化されるわけではありません。どのログをどこへ送るか、どの操作を許可するかは、採用する構成ごとに決めます。
単体エージェントと開発フレームワークの比較
Claude CodeやCursorは、リポジトリの調査、コード編集、テスト、コマンド実行を進める個別エージェントです。LangGraphやAutoGenは、複数の役割やノードを定義してエージェントアプリケーションを構築するフレームワークです。Omnigentは、それらとは異なる位置で、既存のハーネスを選択・合成・統制する役割を担います。
比較軸 | 単体エージェント | エージェント開発フレームワーク | Omnigent |
|---|---|---|---|
代表例 | Claude Code、Codex、Cursor | LangGraph、AutoGen、CrewAI | Databricks Omnigent |
主な用途 | コード作成、調査、テスト、操作実行 | 自作エージェントと処理フローの構築 | 複数ハーネスの統合、共有、制御 |
管理単位 | 端末、リポジトリ、個別セッション | ノード、グラフ、状態、ツール | Runner、Server、セッション、ポリシー |
ガバナンスの置き場 | 製品設定や端末設定ごと | アプリケーション実装ごと | 複数エージェントをまたぐ共通レイヤー |
導入時の注意点 | 設定とログがツールごとに分散しやすい | 開発・保守するコードが増える | 上位レイヤーと運用責任が追加される |
対応エージェントの範囲
Omnigentの公式GitHubリポジトリでは、Claude Code、Codex、Cursor、OpenCode、Hermes、Piなどへの対応が案内されています。Databricksの公開情報では、AntigravityやOpenAI Agents SDK、Claude Agents SDKを使ったカスタムエージェントも対象として示されています。
対応という表現は、すべてのエージェントの全機能、すべてのバージョン、すべての認証方式を保証する意味ではありません。CLIの出力形式、ログイン方式、ツール仕様が変われば、アダプターの動作が変化する可能性があります。本番接続を判断する前に、Omnigent、対象エージェント、OS、サンドボックス、モデルプロバイダーの組み合わせを固定し、起動、停止、ログ取得、権限拒否を再現します。
セッション引き継ぎの境界
複数のエージェントを切り替えるとき、利用者は同じ背景情報を何度も入力せずに済む場合があります。しかし、セッション共有は情報共有でもあります。顧客情報、認証情報、未公開ソースコード、障害情報を含む履歴を無制限に次のエージェントへ渡す設計は避けます。
社内限定データを扱う場合は、引き継ぐ情報を「作業目的」「必要な要約」「参照してよいファイル」「許可済みのツール」に分けます。秘密情報は値そのものではなくシークレット名だけを渡し、個人情報はマスキング済みの要約に変換します。履歴を保持する必要がない処理では、要約後に前セッションを破棄する設計にすると、別案件や別部署への不要な文脈流出を抑えられます。
▶ 関連記事: MCP企業導入のセキュリティ完全ガイド|ガバナンスとリスク対策
▶ 関連記事: MCP企業導入のセキュリティ完全ガイド|ガバナンスとリスク対策
▲ OmnigentにおけるRunnerとServerの分離構造と周辺基盤との関係性
Omnigentの導入前に確認するセットアップと実行環境
Omnigentの導入では、インストールの成功より先に、実行場所、認証方式、接続データ、停止経路を決める必要があります。
Databricks環境でのインストール
Databricksワークスペースをモデルプロバイダーとして使う構成では、Omnigent公式GitHubリポジトリがuv tool install "omnigent[databricks]"をインストールコマンドとして案内しています。uvを使うことで、PythonツールとしてOmnigentを分離して導入しやすくなります。
ただし、このコマンドだけで企業向けの初期設定が完了するわけではありません。検証環境では、まず公開リポジトリまたはダミーデータだけを対象にし、読み取り専用の認証情報で起動します。その後、セッション開始、エージェント切り替え、ツール実行、費用記録、停止操作、ログの保存を一連で試験します。少なくとも一度は、意図的に許可されていない操作を実行させ、拒否または承認待ちになることを確認します。
OAuth認証と非人間ID
DatabricksでOmnigentを利用する場合、ユーザー認証とワークスペースへのアクセス設計が必要です。人間の管理者アカウントをエージェントへそのまま渡すと、プロンプトインジェクションや誤操作が発生した際に、管理者権限でデータや設定が変更されるおそれがあります。
書き込み操作を伴うエージェントには、人間用の長期セッションではなく、用途別の非人間アイデンティティを割り当てます。台帳には、エージェントID、所有部門、技術責任者、接続先、権限、有効期限、更新日、停止方法を記録します。読み取り用IDと更新用IDを分離し、削除、公開、権限変更に使う資格情報は短命化します。所有者が異動・退職した場合に失効する仕組みを作れないなら、本番の書き込み権限は付与しません。
Windows利用時の制約
Azure DatabricksのOmnigent公式ドキュメントでは、ネイティブWindowsはサポート対象外と案内されています。Windows端末で検証する場合は、WSL2上のLinux環境を前提に構成し、端末管理とファイル共有の境界を明確にします。
WSL2を利用するときは、Windows側のホームディレクトリ、SSH鍵、クラウド資格情報、ブラウザのプロファイルがエージェントから無制限に参照できない状態にします。プロジェクトの作業ディレクトリをLinux側へ限定し、資格情報は環境変数へ恒久保存せず、秘密情報管理基盤から短時間だけ払い出します。端末のフルディスク暗号化、EDR、OS更新、画面ロック、リモートワイプが有効な管理端末だけを利用対象にします。
クラウドサンドボックスの構成
Omnigent公式GitHubリポジトリでは、Modal、Daytona、Islo、E2B、CoreWeave、Kubernetes、OpenShell、Boxlite、Databricksなどのクラウドサンドボックスでセッションを実行できると案内されています。対応サンドボックスの最新一覧は公式GitHubリポジトリのREADMEで確認してください。実行環境を隔離すると、エージェントがローカル端末の全ファイルや常設認証情報に触れる範囲を減らせます。
隔離環境には、対象リポジトリの作業コピー、限定されたネットワーク許可先、短命トークン、必要最小限のツールだけを渡します。成果物はプルリクエスト、承認済みアーティファクト、マスキング済みログに限定し、処理終了後はワークスペースと資格情報を破棄します。サンドボックスの破棄、永続ボリューム、外部通信、リージョン、ログ保管の仕様が確認できれば機密度に応じた限定検証へ進み、確認できなければ公開データだけを扱う検証に留めます。
初期検証のチェックリスト
最初の検証では便利な機能を広く試すより、統制が働かない条件を先に見つけます。
対象エージェント、Omnigent、OS、ランタイムのバージョンを固定します。
公開データまたはダミーデータだけをサンドボックスへ配置します。
読み取り専用の短命IDで起動し、管理者IDを利用しません。
許可外ドメインへの送信、削除操作、権限変更を試験し、停止または承認待ちになるかを記録します。
利用者、エージェント、モデル、ツール、費用、結果を同じ相関IDで追跡できるかを確認します。
トークン失効、実行キュー停止、サンドボックス破棄の三つの停止手段を実演します。
Omnigentで実現するAIエージェントガバナンス
Omnigentの価値は、複数エージェントの利用を許可することではなく、利用条件と実行履歴を共通ルールで扱える点にあります。
コストポリシーの具体例
DatabricksはOmnigentのコストポリシーとして、100ドルを消費するごとにエージェントを一時停止し、継続するかを確認する設定例を公開しています。これは月末の請求書を見てから異常に気付く運用ではなく、セッション実行中に人間の判断を挟む制御です。
企業では100ドルという固定額をそのまま採用するのではなく、業務リスクと予算に応じて閾値を決めます。たとえば、日次予算が5万円の検証環境なら、2万円で通知・3万5,000円で部門責任者確認・5万円で停止という三段階に分けます。障害対応など緊急度が高い業務向けには、終了時刻付きの例外枠を設定します(期限のない例外枠は恒久的な上限緩和に転化します)。費用停止の四層設計(1回あたり・セッション・日次・月次)と例外申請フローの詳細は「AIエージェントガバナンスを定着させる運用設計」のセクションで整理します。
文脈型ポリシーの考え方
Databricks上のOmnigentでは、組み込みのコンテキストポリシーがポリシーハンドラーとして案内されています。反対に、任意コードを実行するカスタムポリシー関数はサポートしないとDatabricks公式ドキュメント(docs.databricks.com › omnigent)は説明しています。この制約はバージョンや提供環境によって変わる可能性があるため、採用時点のドキュメントで「policy handler」または「context policy」の項目を確認し、自社で必要なポリシーロジックが組み込み機能の範囲内かどうかを判断してください。範囲外のロジックはAI GatewayやSIEMなど外側のレイヤーで補う設計にします。
この制約は、導入設計で見落としやすい点です。自社独自の審査ロジック、チケット照合、社内承認DB参照、リスクスコア計算をポリシー内で自由に実行できる前提にはしません。組み込みポリシーで実現できる範囲を検証し、実現できない制御はAI Gateway、API Gateway、ワークフロー、SIEM、ID基盤など外側のレイヤーで補います。
文脈型の判断では、削除という単語の有無ではなく、実行者、対象環境、データ分類、件数、送信先、直前の操作を組み合わせます。開発環境の一時テーブルを10件削除する操作は自動許可し、本番の顧客テーブルを100件更新する操作は承認待ちにする、といった条件分岐です。ポリシー判定サービスが停止した場合に書き込みを拒否するフェイルクローズも、顧客影響と復旧手順を含めて決めます。
エージェントの切り替えと合成
Databricksは公式GitHubで、Omnigentをハーネスやモデルをまたいでポリシー適用やエージェントのオーケストレーションが可能な構成として紹介しています。ツール、プロンプト、スキルの横断的な扱いについては、公式ドキュメントで採用バージョンの対応範囲を確認してから設計してください。調査、実装、レビューを異なるエージェントへ分担させる場合、作業目的と許可権限を役割ごとに分けられます。
たとえば調査エージェントには社内文書の検索権限だけを渡し、実装エージェントには隔離された作業ブランチへの書き込みを許可し、レビューエージェントには差分の参照権限だけを付けます。この分離により、レビュー担当のエージェントが本番環境を変更したり、調査担当が機密データを外部へ送ったりする経路を減らします。
やってはいけないのは、複数エージェントを使うこと自体を高性能化と捉え、同じ権限・同じ秘密情報・同じ外部通信を全エージェントへ配ることです。エージェント数が増えるほど、再試行、重複呼び出し、履歴共有、ログ量、依存関係も増えます。タスクごとに入力、出力、権限、最大再試行回数、タイムアウト、停止地点を定義し、失敗時にどのエージェントから再開するかを決めます。
共有セッションと人間承認
共有セッションは、チームでのレビューや引き継ぎに役立つ一方、会話履歴や作業状態を広げる機能でもあります。共有URLを知る人が誰でも高権限操作を継続できる構成にはしません。閲覧権限、操作権限、承認権限を分け、共有時にはセッションの有効期限を設定します。
人間承認は、すべての操作に適用すると作業が滞留します。読み取り、作業領域でのファイル作成、単体テストは自動実行に寄せ、削除、外部送信、権限変更、本番反映、クラウド資源作成を承認対象にします。承認ログには、承認者、対象操作、差分、対象件数、承認時刻、失効時刻を残し、後から「誰が何を承認したか」を再現できるようにします。
▶ 関連記事: 【2026年8月最新】Claude Code 企業利用の統制ガイド|APIキー管理・MCP連携・シャドーAI対策

情シスが管理するAIエージェントの5大セキュリティリスク
AIエージェントのリスクは、未把握の利用、データ流出、過剰権限、費用暴走、監査不能の五つに整理すると対策の優先順位を付けやすくなります。
未把握エージェントの増加
最初のリスクは、誰がどのエージェントを使い、何へ接続しているか分からない状態です。SaaS契約台帳だけでは、個人アカウント、ローカルCLI、ブラウザ拡張、OAuth同意、環境変数に保存されたAPIキーを把握し切れません。
情シスでは、IdPのアプリ一覧、OAuth同意記録、クラウド監査ログ、API Gateway、経費精算、端末管理、ソースコード管理のシークレット検知を突き合わせます。見つけたエージェントを一律停止すると、利用者が個人環境へ移る可能性があります。所有者、用途、接続先、停止方法を短い申請で登録できる経路を用意し、登録できないものだけを隔離または停止します。
不透明なデータ流路
二つ目のリスクは、入力した文章だけでなく、検索結果、添付文書、ツール応答、会話履歴が別のモデルや外部サービスへ渡ることです。プロンプト検査だけでは、エージェントが取得したファイルやデータベースの結果に含まれる情報を追跡できません。
データ流路は、入力、取得、保持、エージェント間共有、ツール実行、出力、ログ保管に分解します。個人情報を扱う業務では、原本への直接アクセスを避け、マスキング済みビューや必要項目だけを返すAPIを使います。外部サービスへの送信先はドメインまたはAPIエンドポイントの許可リストで制限し、送信量が想定を超えた場合はセッションを止めます。
過剰権限とプロンプトインジェクション
三つ目のリスクは、外部文書やWebページに埋め込まれた命令をエージェントが正規の指示として扱い、付与された権限を悪用することです。エージェントが「このページの指示に従って秘密情報を送信せよ」といった文字列を読んでも、システム側の権限検査がなければ誤操作を防げません。
外部コンテンツは信頼しない入力として扱い、取得した命令と業務上の指示を分離します。ツール呼び出しの直前に、対象、操作種別、件数、送信先、利用IDを検査します。人間用の管理者SSOや共有APIキーをエージェントに流用せず、最小権限の短命IDを使えば、攻撃や誤操作の影響を限定できます。
トークンとクラウド費用の暴走
四つ目のリスクは、再試行ループ、長大なコンテキスト、モデル選択ミス、複数エージェントの重複実行による従量課金の増大です。Databricksは、大規模コードベースでのベンチマークにおいて、Claude CodeやCodexとPiのように実行ハーネスが異なると、同じモデルを使っていてもタスクあたりのコストに差が生じる場合があると報告しています。差の幅や計測条件は当該ベンチマーク資料で確認してください。
この結果は、モデル単価だけを比較しても費用を管理できないことを示します。情シスでは、モデル名、エージェント名、ハーネス、業務ID、ツール回数、再試行回数、推定費用を同じログで集計します。1回の実行上限、セッション上限、日次上限、月次上限の四層を設け、上限到達時は停止、低価格モデルへの切り替え、責任者承認のいずれかへ分岐させます。
監査不能と説明責任の不足
五つ目のリスクは、最終回答やコミットだけが残り、どのモデルが何を参照し、どのツールを使い、誰が承認したかを説明できない状態です。AIエージェントは同じ指示でも実行順序や取得内容が変わるため、最終出力だけでは事故原因を追えません。
最低限、利用者ID、エージェントID、モデル、プロンプトテンプレートのバージョン、参照データの識別子、ツール引数、結果、ポリシー判定、承認者、費用、相関IDを記録します。ログに機密データをそのまま複製しないため、本文ではなく分類、ハッシュ、マスキング済み要約を保存します。書き込み操作のログを取得できない構成なら、本番データの更新は許可せず、読み取り専用の検証に限定します。
▶ 関連記事: Vibe Coding × 企業統制|AIコーディングエージェントのガバナンス設計
▶ 関連記事: 【2026】生成AIセキュリティのベストプラクティスと情シス対策
Omnigent導入時のデメリットと失敗パターン
Omnigentは複数エージェントの統制を助けますが、管理レイヤーを増やすため、導入範囲を誤ると運用負荷と障害点を増やします。
初期段階の仕様変化
Omnigentは比較的新しいOSSであり、対応エージェント、アダプター、実行環境、ポリシー仕様が更新される可能性があります。初期段階の製品を本番へ導入する場合、最新の機能紹介だけで設計を固定すると、更新で動作や統制範囲が変わるリスクがあります。
対策は、リリースごとの変更を受け入れることではなく、採用バージョンを固定した検証を行うことです。OS、Python、Omnigent、対象エージェント、モデルプロバイダー、サンドボックス、認証方式を構成台帳に記録します。更新時は、起動、認証、アクセス拒否、費用制限、ログ、停止の回帰試験に通ったものだけを昇格させます。
管理レイヤーの過剰追加
単一のエージェントをローカルで使うだけの組織に、Runner、Server、サンドボックス、AI Gateway、SIEM連携、台帳運用を一度に追加すると、利用者は承認済みの経路を避けやすくなります。統制のために作った基盤が、かえって野良AI利用を増やす失敗です。
利用者が必要とする操作が公開情報の要約だけなら、読み取り専用環境と少数の許可モデルから始めます。複数エージェントの切り替え、社内リポジトリへの書き込み、外部API実行が必要になった時点で、サンドボックスや承認フローを追加します。統制強度は対象データと操作権限に合わせて上げ、すべての業務を同じ厳格さで扱わないことが定着につながります。
共有セッションの権限混同
共有セッションは便利ですが、閲覧者と実行者、承認者の区別がないと、URLを共有しただけで高権限操作へ参加できる構成になり得ます。特に、セッションに資格情報、ソースコード、顧客情報、実行履歴が含まれる場合、共有範囲の誤りは情報漏えいに直結します。
共有は、閲覧専用、コメント可能、実行可能、承認可能に権限を分けます。セッションには期限を付け、終了後にトークン、作業ディレクトリ、キャッシュを破棄します。誰が閲覧したかを記録できない構成では、機密データを含むセッションを共有せず、マスキング済みの成果物だけをレビュー対象にします。
個人契約と共有キーの流用
個人向けサブスクリプションのログイン情報やOAuthトークンを、チームの共通Runnerや自動処理へ転用する運用は避けてください。請求主体、利用者追跡、退職時の失効、責任分界が曖昧になり、障害時に誰の操作か特定できなくなります。各サービスの利用規約における法人・自動処理向け利用の条件は、それぞれの規約ページで確認してください。
法人のAPI契約または組織管理可能な認証方式を使い、エージェント単位で資格情報を分けます。費用を部門別に集計する必要がある場合は、共通キーを使う代わりに、業務IDやコストセンターを実行リクエストへ必須付与する仕組みを作ります。所属不明のAPIキーが見つかった場合は、所有者登録が完了するまで書き込み権限を外します。
ポリシーだけに依存する設計
Omnigentのポリシーで危険な操作を抑止できても、ネットワークが全許可、資格情報が長期、データベース権限が管理者、ログが未保存なら、単一の制御失敗で影響範囲が広がります。ポリシーは多層防御の一部として扱います。
最小権限ID、ネットワーク許可リスト、サンドボックス、承認フロー、バックアップ、監査ログ、停止手段を組み合わせます。障害時には、ポリシーを変更するより先に、トークン失効、実行キュー停止、ネットワーク遮断、サンドボックス破棄の順で被害を止めます。停止後にログを保全し、原因となったプロンプト、外部入力、ツール権限、ポリシー判定を分析します。
▶ 関連記事: 【2026】生成AIセキュリティのベストプラクティスと情シス対策
Databricks Omnigentの選定基準と企業導入の判断
Databricks Omnigentは、複数エージェントの統制が必要で、実行ログと権限を共通化できる組織で評価対象になります。
導入判断に向く条件
Claude Code、Codex、Cursor、自作エージェントなどが部門ごとに使われ、同じリポジトリ、クラウド、データ基盤、業務APIへ接続している場合は、共通レイヤーの導入効果を検証しやすい状態です。個別ツールごとに設定した費用上限、承認基準、ログ形式、サンドボックスの運用がばらばらなら、横断統制の必要性が高まります。
Databricksをデータ・AI基盤として利用している企業では、Omnigent、Unity AI Gateway、Unity Catalog、MLflow Tracingを役割分担させる構成を検討できます。DatabricksはOmnigentをオープンソースとして公開しています。Unity AI Gatewayについては、提供形態や無償・有償の範囲が契約・構成により異なるため、Databricksの公式料金ページおよび契約条件を確認してください。ただし、無償提供の範囲と、実行コンピュート、モデル利用、ログ保管、ネットワーク、サンドボックスにかかる費用は分けて試算します。
見送りまたは限定検証に留める条件
単一のエージェントで作業が完結し、扱うデータが公開情報のみで、書き込み・外部送信・認証情報利用がない場合は、メタハーネスの導入よりも端末設定と利用ルールの整備が先です。また、長期サポート、固定仕様、24時間の商用保守を最優先条件とし、初期段階のOSSを運用する体制がない場合も、本番利用を急ぎません。
Azure DatabricksでのネイティブWindows非対応、組み込みコンテキストポリシーのみのサポート、リージョンやプレビュー機能への依存は、導入対象を狭める条件になります。必要なOS、ポリシー、サンドボックス、ログ連携が検証環境で再現できれば限定業務へ進み、再現できなければ別の統制方法で同じ要件を満たします。
料金の考え方
OmnigentのOSS本体はApache License 2.0で公開されていますが、企業利用の総費用が無料になるわけではありません。LLM APIまたはモデルエンドポイントの従量課金、Databricksのコンピュート、サンドボックス、ログ保管、ネットワーク、秘密情報管理、運用担当者の工数が発生します。
費用項目 | OSS運用時 | Databricks環境での運用時 | 確認する判断材料 |
|---|---|---|---|
Omnigent本体 | Apache License 2.0の範囲で利用(ライセンス費は不要だが、実行環境・モデル・サポートは別途費用が発生する場合があります) | 提供条件はDatabricksの対象機能・契約に依存 | 採用バージョンと利用条件、Databricks契約内容 |
モデル利用 | 外部APIまたは自社モデルの従量費用 | モデルエンドポイントやGatewayの利用費用 | トークン、リクエスト、モデル別単価 |
実行環境 | VM、Kubernetes、サンドボックス費用 | ワークスペースとコンピュート費用 | 同時実行数、起動時間、停止時間 |
監査・保管 | ログ基盤、SIEM、ストレージ費用 | Tracing、カタログ、外部SIEM連携費用 | 保存期間、ログ量、検索頻度 |
運用工数 | パッチ、障害対応、構成管理 | 設定、権限、連携、変更管理 | 責任者、停止手順、変更審査 |
費用対効果を測るときは、モデル費だけを削減目標にしません。ハーネス差で同一モデルのタスク費用が2倍以上変わるというDatabricksの観察結果を踏まえ、タスク成功率、再試行回数、レビュー時間、実行時間、承認待ち時間、インシデント件数を同じ期間で比較します。
国内企業事例の読み方
Omnigentそのものの国内導入事例として、公開情報で定量成果を確認できる企業事例は限られます。そのため、Databricksの導入事例をOmnigentの効果として扱うことはできません。ただし、データ・AI基盤の統合とガバナンスの必要性を考える参考にはなります。
企業 | 業種 | 公開された施策 | 公開された成果 | Omnigentとの関係 |
|---|---|---|---|---|
マネーフォワード | 金融SaaS | データ基盤とUnity Catalogの活用 | バッチ処理時間の短縮を報告(詳細は当社公表資料を参照) | Omnigent導入事例ではありません |
IVRy | 電話SaaS | データとAIワークロードの統合 | 対象ワークロードのコスト削減を報告(詳細は当社公表資料を参照) | Omnigent導入事例ではありません |
データ・ワン | データマーケティング | Unity Catalogを中心とした一元管理 | 対象ワークロードの処理コスト削減を報告(詳細は当社公表資料を参照) | Omnigent導入事例ではありません |
これらの事例は、対象ワークロードや導入条件が異なるため、そのまま自社の削減率に置き換えません。自社では、PoCの開始時点で実行時間、トークン費用、再試行、レビュー工数、ログ取得率を測定し、導入前後で比較できる基準値を作ります。
▶ 関連記事: 【2026年8月最新】Claude Code 企業利用の統制ガイド|APIキー管理・MCP連携・シャドーAI対策
▶ 関連記事: シャドーMCP対策ガイド|AIコーディングが招く新たなデータ漏洩リスクと検知の入口
▲ 自社におけるOmnigent導入の必要性を判定する意思決定フロー
AIエージェントガバナンスを定着させる運用設計
AIエージェントガバナンスは、導入可否を一度決める作業ではなく、台帳、権限、費用、ログ、停止を継続して運用する仕組みです。
AIエージェント台帳の項目
台帳は、SaaS台帳と同じように製品名だけを管理するものではありません。AIエージェントはモデル、ツール、ID、データ、実行環境を組み合わせて動くため、構成単位で記録します。
台帳項目 | 記録内容 | 未記入時の処理 |
|---|---|---|
エージェントID | 一意の識別子、実行環境、バージョン | 本番接続を許可しません |
所有者 | 部門責任者、技術責任者、運用担当者 | 所有者不明として停止候補にします |
利用目的 | 対象業務、入力データ、出力先 | 公開データの検証だけに限定します |
認証情報 | 非人間ID、権限、有効期限、保管先 | 共有IDや管理者IDを失効させます |
費用統制 | モデル、日次・月次上限、例外承認者 | 低い暫定上限で起動します |
停止方法 | トークン失効、キュー停止、環境破棄 | 書き込み操作を許可しません |
監査ログ | 保存先、相関ID、保管期間、閲覧権限 | 本番データへの接続を許可しません |
30日間の導入フェーズ
導入を急ぐ場合でも、初日から本番の書き込み権限を渡しません。最初の30日間は、可視化、隔離、限定実行、運用訓練の順に進めます。
期間 | 実施内容 | 完了条件 |
|---|---|---|
1〜5日目 | AIサービス、エージェント、OAuth同意、APIキー、実行環境を棚卸しします。 | 所有者不明と接続先不明の対象を一覧化します。 |
6〜10日目 | 台帳へ権限、データ分類、費用上限、停止方法、ログ保存先を登録します。 | 高リスク対象を隔離または読み取り専用へ移します。 |
11〜20日目 | Omnigent、認証、サンドボックス、費用制限、承認フローを検証環境で試験します。 | 危険操作が拒否または承認待ちになり、ログを追跡できます。 |
21〜30日目 | 限定した業務で実行し、停止訓練、例外申請、障害連絡を実施します。 | 主体、操作、費用、承認、停止を同じ事象として説明できます。 |
停止基準と例外処理
停止基準は事故発生後ではなく、導入前に数値と操作種別で決めます。たとえば、未許可ドメインへの送信、予定件数の10倍を超える更新、日次予算の100%到達、監査イベントの5分以上の欠落、所有者の退職・異動を停止条件に設定します。
例外処理では、対象セッション、許可する操作、上限額、終了時刻、承認者を記録します。障害対応で例外を認める場合も、期限切れ時に通常ポリシーへ自動復帰する構成にします。例外申請が毎月発生する業務は、利用者の逸脱として扱うのではなく、標準ポリシーの閾値や業務区分を見直します。
AdminaなどのSaaS管理との責任分界
Omnigentはエージェントの実行、共有、ポリシー、サンドボックスを扱うレイヤーとして評価できます。一方で、SaaS契約、退職者アカウント、未利用ライセンス、経費に現れる個人契約を把握するには、IdP、SaaS管理、経費、MDMなどの別基盤が必要です。
OmnigentとAdminaの専用コネクターや直接連携については、本記事で参照した公開情報では公式仕様として確認できません。そのため、片方の製品がもう片方の操作を自動停止するといった前提では設計しません。エージェントID、所有者ID、SaaSアプリID、非人間IDを共通台帳またはSIEMで関連付け、検知と停止の責任者を明確にします。
▶ 関連記事: シャドーMCP対策ガイド|AIコーディングが招く新たなデータ漏洩リスクと検知の入口
▲ 安全にAIエージェントガバナンスを定着させる30日間の導入手順
Omnigentに関するよくある質問
Omnigentの位置付け、料金、Windows対応、AIエージェントガバナンスに関する判断を簡潔に整理します。
OmnigentとLangGraphの違い
Q:OmnigentとLangGraphは競合しますか?
OmnigentはOSSのメタハーネスとして既存エージェントやハーネスを統合・制御する上位レイヤーです。LangGraphのような処理フロー構築フレームワークとは異なる位置付けとされており、自作エージェントをLangGraphで構築しその実行統制をOmnigentや周辺基盤で設計する構成も考えられます。LangGraphの詳細な位置付けはLangGraph公式ドキュメントで確認してください。
Cursorとの関係
Q:Cursorを使っている企業にもOmnigentは必要ですか?
Cursorだけを利用し、データ接続や書き込み操作が限定されている場合は、端末管理、SSO、ログ取得、利用ルールを先に整えます。Cursorに加えてClaude Code、Codex、自作エージェントなどが混在し、共通の費用・権限・監査ポリシーが必要ならOmnigentを比較対象に含めます。
料金と無償利用
Q:Omnigentは無料で使えますか?
OmnigentのOSS本体はApache License 2.0で公開されていますが、モデルAPI、Databricksコンピュート、サンドボックス、ログ保管、ネットワーク、運用工数は別途発生します。導入費用を算定するときは、ライセンス費だけでなく、タスク単位のモデル費と実行環境費を含めて比較します。
Windows環境の利用
Q:Windows端末でOmnigentを使えますか?
Azure Databricksの公式ドキュメントではネイティブWindowsはサポートされていません。Windows端末で検証する場合はWSL2上のLinux環境を使い、Windows側の資格情報やホームディレクトリを無制限に参照できない構成にします。
本番導入の最低条件
Q:本番導入へ進める最低条件は何ですか?
所有者、非人間ID、最小権限、費用上限、監査ログ、停止手順の六項目を確認できることが最低条件です。書き込み操作について、承認前には実行されず、停止後には資格情報と実行環境を無効化できることを検証できれば、限定範囲の本番利用へ進みます。
まとめ
AIエージェント統制を始めるための最初の一歩
Omnigentは、Claude Code、Codex、Cursor、自作エージェントなどを統合し、共通のセッション、実行環境、ポリシーを扱うDatabricks発のメタハーネスです。RunnerとServerの構造、対応エージェント、コスト上限の設定(例:100ドルごとに一時停止して継続を確認)、サンドボックス対応は、複数エージェントを使う企業にとって評価材料になります。
明日から着手する作業は、Omnigentのインストールではなく、社内で動くAIエージェントの棚卸しです。所有者、実行ID、接続先、データ分類、費用上限、停止方法を台帳へ記録し、空欄があるエージェントは本番データから隔離します。そのうえで、ログ取得、短命ID、サンドボックス、承認フロー、費用停止を検証環境で再現できる場合に、Databricks Omnigentの限定評価へ進みます。
AIエージェントガバナンスでは、単一ツールの導入よりも、実行中の権限と費用を止められる運用が成果を左右します。複数エージェントに共通ポリシーが必要な組織ではOmnigentを評価し、SaaS契約やアカウント管理はIdP、MDM、SaaS管理基盤と責任分界を分けて運用します。
本記事の内容に誤り等がございましたら、こちらからご連絡ください。
監修
Admina Team
情シス業務に関するお役立ち情報をマネーフォワード Adminaが提供します。
SaaS・アカウント・デバイスの管理を自動化し、IT資産の可視化とセキュリティ統制を実現。
従業員の入退社対応や棚卸し作業の工数を削減し、情報システム部門の運用負荷を大幅に軽減します。
中小企業から大企業まで、情シス・管理部門・経営層のすべてに頼れるIT管理プラットフォームです。