
>
>
公開日
最終更新日
Claude Mythos(クロード・ミュトス)は、Anthropicが開発した、ソフトウェアの脆弱性発見と攻撃コードの構築に高い能力を持つAIモデルです。導入を考える情報システム部門(情シス)は、Claude Securityで検出結果や修正案を受け取る利用と、Mythos本体を直接操作する利用を分けて判断します。
IPAは、2026年4月に発表されたプレビュー版について、能力の高さから提供先の選定に米国政府が介入する状況を『情報セキュリティ白書2026』で取り上げています。高い検出能力を使える場合でも、修正の承認やサービス停止への備えは利用企業が担います。
本記事では2026年10月時点の情報を基に、Claude Codeとの連携、セーフガード、Amazon BedrockやGoogle Cloud経由の利用条件を整理します。Mozillaや日立製作所の成果を参照しながら、契約前の判断材料と導入後の運用手順を示します。

Claude Mythosとは
Mythosの評価では、コードの解析や推論を通じた脆弱性の発見から攻撃成立性の分析まで、どこまで任せられるかを見ます。一般的なコーディング支援とは異なり、導入時はベンチマークの数値だけでなく、コンテキストウィンドウ、利用ステータス、権限範囲、SWE-bench Proなど評価ごとの条件も分けて扱います。
最初に確認する5項目(調達・契約担当は1と5、開発・運用担当は2と4、セキュリティ責任者は3から読むと、自分の判断に必要な箇所へ進めます)
Claude Securityによる成果物の利用と、Mythos本体へのアクセスは別の権限です。
一般のClaude Codeでの作業権限を取得しても、Mythosを自由に呼び出せる権限にはなりません。
セーフガードの解除・緩和は、対象モデルと審査された利用範囲に従って扱います。
情シスは、検出件数より先に、修正担当者・承認者・停止時の代替手順を決めます。
契約前に、利用モデルのバージョン・提供経路・契約主体・利用地域・用途を台帳へ固定します。
脆弱性発見と一般的なコード支援の違い
Mythosの導入では、コードの生成精度に加えて、攻撃につながる問題をどこまで発見できるかを評価します。
一般的なコード支援では、実装案やテストコードの作成が中心です。一方、セキュリティ評価では、入力検証の不足、権限境界、複数の処理にまたがる不整合などを分析し、実際に問題が成立する条件まで絞り込みます。その成果を開発に戻す際は、問題箇所の指摘、影響範囲、修正案、回帰テストを分けて記録します。攻撃に利用できる情報を扱うため、通常の開発支援より厳しく出力先を制限します。
カバードモデルとしてのアクセス管理
Mythosは、利用者と利用目的を限定するアクセス管理の対象です。
IPAの人材育成事業に掲載された資料は、能力の高さから特別な安全管理措置を適用し、限定された組織だけが利用できるAIをカバードモデル(Covered Model)と整理し、Claude Mythosを具体例に挙げています。IPAが『情報セキュリティ白書2026』で取り上げたプレビュー版の提供先選定も、この分類と同様に特定の組織に限った扱いであり、すべてのClaude製品に共通する契約名称や、日本国内での一律の法的区分とは読み替えないようにします。企業は、実際に契約するモデル、提供経路、利用者の条件を個別に扱います。
利用目的別の役割分担
最初に利用したい成果物を決めると、必要なサービスと権限を切り分けられます。
知りたいこと・行いたいこと | 主に扱う機能 | 情シスの判断 |
|---|---|---|
リポジトリの脆弱性と修正案を受け取りたい | Claude Securityによるスキャン | 対象リポジトリ、成果物の閲覧者、修正承認者を設定します。 |
提案された修正を実装したい | Claude Codeによる開発作業 | 専用ブランチで修正し、レビューとテストを経て反映します。 |
Mythos本体に高度なセキュリティ評価を依頼したい | 審査対象のモデルアクセス | 申請・承認された権限の範囲で検証します。 |
Amazon BedrockやGoogle Cloudから利用したい | クラウドごとのモデル提供経路 | モデルID、契約主体、利用地域、用途制限を調達条件として扱います。 |
Claude CodeとMythosの関係を調べる場合は、スキャンを担当するモデルと、修正作業を進める開発ツールを分けると整理できます。
提供条件と公開情報の範囲
2026年10月時点では、利用経路ごとに公表されている内容を分けて判断します。
本記事で参照するAnthropicのMythos・Glasswing案内には、Claude Mythos 5.1の価格とアクセス申請経路があります。Mythos 5.1のモデルIDは公式ドキュメントで公開されており、Claude APIでは「claude-mythos-5-1」、Amazon Bedrockでは「anthropic.claude-mythos-5-1」です(Claude Mythos 5.1の仕様)。利用できるのはAnthropicの検証プログラムで承認された組織に限られ、Anthropicは現時点の提供先を米国の一部組織としています(Claude Fable 5.1・Mythos 5.1の発表)。Claude SecurityでのMythosによるスキャンは、既存プランの標準のトークン利用として課金され、別料金のアドオンはないと案内されています(Anthropicの発表)。審査の全評価項目は公表されていないため、以下では契約条件と運用上の判断を分けて説明します。
後継モデルを含む構成の整理は、Claude Mythos 5.1公開|情シスが押さえる性能・提供体制・監視リスクも参照できます。
▶ 関連記事: Claude Fable 5恒久提供新料金プランと従量課金への移行対策
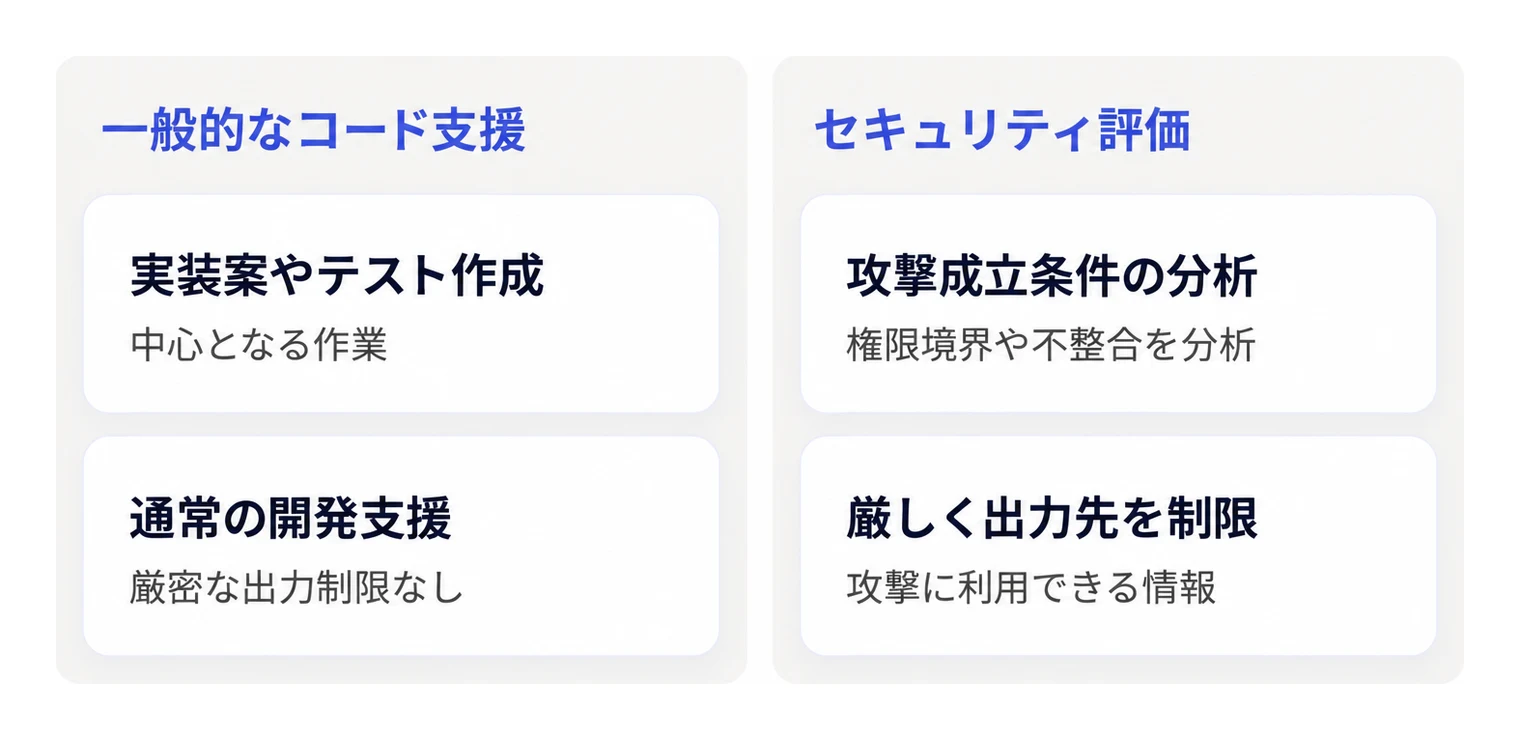
▲ 一般的なコード支援とClaude Mythosによるセキュリティ評価の役割と出力管理の違い。
Claude SecurityとClaude Codeの役割分担
Claude Securityで脆弱性を検出し、Claude Codeで修正する場合も、モデルへのアクセス権とコード変更の権限は別々に管理します。
Enterprise向け成果物利用とモデル直接利用の境界
Claude Enterpriseを契約している場合も、サービス内の成果物利用をMythos本体の自由利用と同一視しないようにします。Claude SecurityはClaude Enterprise向けのパブリックベータで、Mythos 5.1を含むモデルで動作し、Cyber Verification Programの承認は不要です。Mythosによるスキャンは、Claude.aiのClaude Securityアプリでのみ実行できます(Claude Security、Mythosの案内)。
社内の運用では、Claude Securityで受け取る検出結果や修正案の閲覧権限と、Mythos本体を任意のプロンプトで操作する権限を別々に付与します。Claude Securityを有効化した部署にも、Claude Codeや別のAPIクライアントからのMythos利用は個別の承認なしに認めません。
社内の申請フォームも分離します。「リポジトリのスキャン申請」には対象と閲覧者を、「修正作業の申請」にはブランチと承認者を記載します。高度なサイバー機能への直接アクセスが必要な部署は、これらと別に利用目的と権限範囲を申請します。部署が同じでも、管理者が権限をまとめて付与しない構成にします。
Web版Claude Codeでの修正フロー
修正案を受け取った開発担当者は、Web版Claude Codeで専用ブランチを使い、テスト結果を添えてレビューに回します。
画面のボタン名や自動連携の有無に依存せず、次の作業順で管理すると、検出から本番反映までの担当範囲を明確にできます。Claude Securityと開発環境を連携する場合も、人間の承認を省略しません。
検出内容の受付:対象リポジトリ、コミット、問題箇所、想定される影響、修正案をチケットに記録します。
修正対象の選別:セキュリティ担当者が再現条件と外部公開の有無を調べ、開発担当者と修正範囲を合意します。
作業環境の準備:Web版Claude Codeで対象リポジトリと作業ブランチを選び、対象コミットをチケットと一致させます。
修正案の実装:該当コードと必要な周辺処理を対象に、変更理由を残して修正します。無関係なリファクタリングは別の変更に分けます。
テストとレビュー:既存テスト、追加した回帰テスト、権限境界のテストを実行し、人間が差分と結果を承認します。
反映と再検査:変更を段階的に展開し、同じ問題の再検査と業務機能の動作確認を終えてからチケットを閉じます。
AIに「この警告を全部直して」と依頼すると、関係のない変更が混ざり、レビュー対象が広がります。担当者は、修正すべき原因、維持する仕様、変更してはいけない公開インターフェースを先に指定します。変更差分を説明できない場合はマージせず、手作業の修正へ戻します。
スキャン権限と修正権限の分離
スキャン用の接続には、解析に必要なリポジトリだけを割り当てます。
読み取り専用で目的を達成できるなら、スキャン用の接続に書き込み権限を付けません。修正担当者にはブランチ作成権限を付与しても、本番ブランチの保護やマージ承認は維持します。外部委託先が修正する場合は、脆弱性レポートの閲覧範囲と契約上の秘密保持義務もそろえます。
コード内のコメントや設定ファイルには、解析ツールへの命令に見える文章が含まれる場合があります。AIが読み込むリポジトリ内の文章を、管理者からの操作命令と同じ権限で扱わないようにします。シークレット、署名鍵、本番データは投入対象から除外し、解析環境から本番への接続も分離します。
料金と運用費用の切り分け
導入稟議では、モデル料金と、検出結果を処理する社内工数を分けて見積もります。
Anthropicの公式案内では、Claude Mythos 5.1のAPI価格は100万入力トークン当たり10ドル、100万出力トークン当たり50ドルです。Claude SecurityでのMythosによるスキャンは、Claude Enterpriseの既存プランの標準のトークン利用として課金され、別料金のアドオンはないと案内されています(Anthropicの発表)。サービス別の課金条件に従って、スキャン費用を積算します。
APIの単純試算では、入力1,000万トークンと出力100万トークンで150ドルです。これは掲載単価だけを使った計算で、税、為替、追加機能、クラウド側の料金は含みません。予算には、初回の広い解析、変更差分の再解析、再実行の回数を分けて計上し、さらにトリアージとレビューの担当時間を加えます。
基本機能の整理は、Claude Code Securityとは?仕組みと情シス向け統制ポイントで、企業契約全体の準備はClaude Fable 5恒久提供新料金プランと従量課金への移行対策で確認できます。
▶ 関連記事: Claude Code Securityとは?仕組みと情シス向け統制ポイント
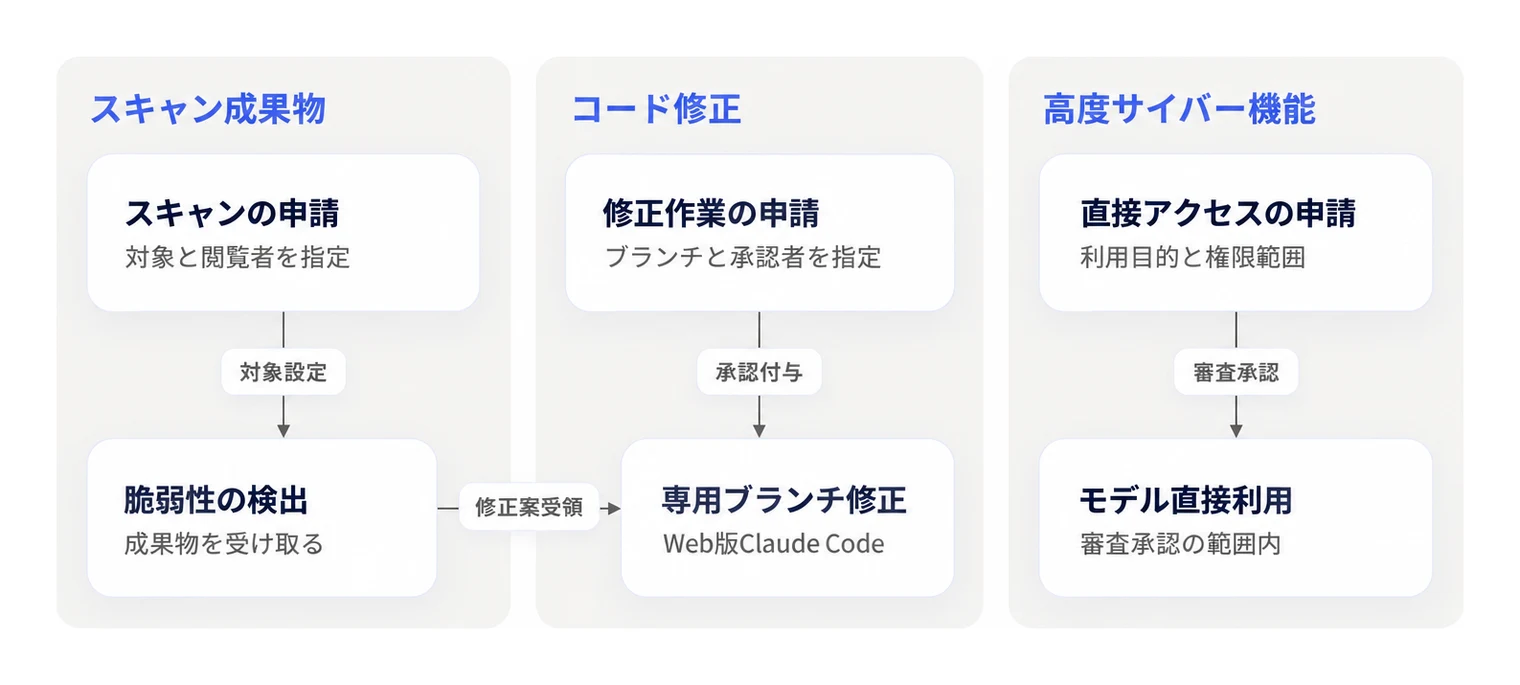
▲ Claude Securityの利用とClaude Code修正作業、モデル直接利用における権限分離の構成。
ベンチマークから読み取れる性能と評価条件
Mythosの性能は、バグ修正、脆弱性発見、攻撃成立性の検証を分けて評価すると、自社で任せる範囲を判断できます。
同じ条件で比較できる実証データ
異なる課題の成功率を一つの順位表にまとめず、評価対象と試行数を添えて読みます。
NTTセキュリティ・ジャパンの2026年4月のレポートは、250回のエクスプロイト作成試行について、Claude Opus 4.6が2回、Claude Sonnet 4.6が0回、Mythosが181回成功した比較を掲載しています。Mythosの成功率は72.4%、Claude Sonnet 4.6は0%です。Anthropicの評価によると、対象はFirefox 147のJavaScriptエンジンの脆弱性で、ブラウザのプロセスサンドボックスなどの多層防御を外した環境での試験です(Anthropicの評価)。この結果は当該評価条件での比較であり、社内システムの72.4%に侵入できるという意味には読み替えません。
評価・実証 | 対象と条件 | 結果 | 自社評価への使い方 |
|---|---|---|---|
エクスプロイト作成比較 | NTTセキュリティ・ジャパンが紹介する250回の試行 | Mythos:181回、72.4%。Opus 4.6:2回。Sonnet 4.6:0回、0% | 高度な検証能力を把握し、実行環境と出力管理の厳しさを決めます。 |
Project Glasswingの初期成果 | Anthropicと約50のパートナー組織による、社会的に重要なソフトウェアの評価 | High/Criticalの脆弱性を1万件以上特定 | 検出増加に対応できる受付・修正体制を先に用意します。 |
自社コードの限定検証 | 同じリポジトリ、コミット、入力範囲、制限時間で実施 | 各社が検証時に測定 | 再現した指摘数、レビュー時間、修正完了までの時間を比較します。 |
AnthropicのProject Glasswing初期成果の公表は、約50のパートナーと1万件以上の深刻・重大な脆弱性を特定したとしています。ただし、この件数だけでは誤検出率や、すべての対象に対する網羅率は計算できません。候補件数、審査対象件数、確定件数、修正済み件数を別々に扱います。
ExploitBenchとコーディング評価の違い
攻撃成立性を測る評価と、GitHub上の修正課題を解く評価では、成功の定義が異なります。
CMUのExploitBenchやV8 sandboxに関する評価を読む場合は、対象の脆弱性、モデルに与えた情報、実行環境、試行上限、成功判定をそろえます。SWE-bench VerifiedやSWE-bench Proを読む場合は、修正対象の課題とテスト通過条件を確認します。
例えば、コード修正の成功率が高くても、本番環境の構成や秘密情報を含む運用条件まで理解しているとは限りません。自社の検証では、指摘の正しさに加えて、修正後の互換性、処理速度、権限設定が維持されるかを測定します。モデルが提示した説明の長さや自信の強さは、採否の基準に含めません。
モデル比較表の作り方
他のモデルと比較する場合も、同じ入力と採点基準を使います。
Claude Mythos Preview、Mythos 5、Mythos 5.1を同じモデルとして一括集計しません。既存環境のモデルを比較対象にする場合も、モデル名と実行日を記録します。セーフガードによる拒否、通信失敗、ツールの実行失敗は、解析したうえでの不正解とは別に集計します。
記録項目 | 残す内容 | 判断への影響 |
|---|---|---|
対象の固定 | リポジトリ、コミット、依存ライブラリ | コード変更による難易度の差を除きます。 |
実行条件 | モデル、入力、ツール権限、時間・費用上限 | 権限や試行量の違いを性能差と混同しません。 |
指摘の品質 | 重複、再現可否、影響、既知の問題との一致 | 開発担当者が処理する実件数を見積もります。 |
修正の品質 | レビュー時間、テスト結果、差し戻し理由 | 検出後に必要な工数まで比較します。 |
既知の脆弱性を含む社内保有コードを使えるなら、修正前後の版をそろえて評価します。使えない場合は、許諾された検証用コードで工程を試し、その結果だけで本番の検出率を約束しないようにします。
▶ 関連記事: 【2026】Claude(クロード)とは?読み方・料金と企業活用
輸出規制の経緯とクラウド経由の提供条件
アクセス再開の発表は、対象国・対象組織・提供経路を分けて読み、日本企業への一律開放と解釈しないようにします。
2026年の発表とアクセス制限の経緯
情シスは、性能の更新履歴と利用権限の変更履歴を別の台帳で管理します。
時期 | 出来事 | 導入判断への影響 |
|---|---|---|
2026年4月 | Claude Mythos PreviewとProject Glasswingの展開 | 防御側の限定利用を前提に、参加経路と用途を整理します。 |
2026年6月 | IPAの人材育成事業資料は、米国政府の輸出規制指令により、Claude Fable 5とMythos 5へのすべてのアクセスが2026年6月12日に停止されたと述べています | 契約上の提供継続だけに依存せず、停止時の手順を用意します。 |
2026年7月1日 | 6月30日の輸出規制解除を受け、AnthropicがFable 5を全世界で再開し、Mythos 5は米国政府の承認を得て米国の一部組織向けに再開(Anthropicの案内) | 米国組織向けの再開と、日本企業向けの利用可否を分けます。 |
2026年9月〜10月 | 9月1日にClaude Mythos 5.1を公開し、提供先は検証プログラムで承認された米国の一部組織。10月6日にCyber Verification Programを拡充し、Opus 5.5・Sonnet 5.5・Mythos 5.1を申請対象として案内(Anthropicの案内) | Claude Security経由の利用とモデルへの直接アクセスを分けて確認し、旧モデルの条件を後継モデルへ自動的に引き継がないようにします。 |
Anthropicの公式案内では、米国政府の承認を受けた2026年7月1日の再開対象は米国の組織です。「輸出規制が解除された」という短い見出しから、全世界・全クラウド・全利用者が同じ条件で利用できるとは判断しません。発注書や社内稟議には、利用する法人と地域を明記します。
また、サービス停止の理由を一つにまとめないようにします。輸出管理、契約上の権限不足、クラウド側の制約、技術的な障害では、復旧の担当窓口も代替手順も異なります。障害票には、発生日時、対象モデル、提供経路、レスポンス、影響した業務を記録します。
Amazon BedrockとGoogle Cloudでの調達判断
Amazon BedrockやGoogle Cloudを契約していても、MythosやFableを自動で利用できるわけではありません。
Bedrockでの提供可否を調べる際に判断すべきなのは、同社モデル全般の取り扱いではなく、利用したいモデルごとの提供条件です。クラウドにClaude製品があるという事実と、特定のMythosモデルを契約できるという事実を分けます。検証環境にモデル名が表示される場合も、本番用途、利用地域、利用者、データの扱いを同じ条件で利用できるかまで調達部門と整理します。
利用経路 | 調達時に固定する項目 | 条件がそろった場合 | 条件がそろわない場合 |
|---|---|---|---|
Anthropic経由の直接利用 | 承認されたモデル、法人、用途、利用者 | 承認範囲内で限定検証を始めます。 | モデル直接利用を前提とした開発を止めます。 |
Claude Security | 契約機能、対象コード、成果物、課金方法 | 検出からレビューまでの工程を試します。 | 既存の解析手段で受付工程を整えます。 |
Amazon Bedrock | モデルID、リージョン、権限、契約上の用途制限 | クラウド側の監査・費用管理を含めて検証します。 | Bedrock経由での提供を前提に予算化しません。 |
Google Cloud | モデルID、提供地域、契約主体、データ処理条件 | 既存のクラウド統制に組み込んで検証します。 | 別経路の利用が社内規程に適合するか判断します。 |
クラウド経由の利用を選ぶ理由が、請求の集約や既存のID管理である場合も、モデル固有の制限は別に残ります。調達担当者は「クラウドの契約」と「高度なモデル機能の利用承認」を同じ承認欄で処理せず、それぞれの証跡を保存します。
データ処理と契約文書の確認範囲
ソースコードを外部サービスへ送る場合は、保存・再利用・削除・再委託の条件を契約単位で扱います。Mythos 5.1の利用には、既定で安全監視のための30日間のデータ保持への同意が必要です(Anthropicの案内)。
自社のコードでも、顧客から預かった実装や第三者の機密情報が含まれる場合があります。契約上アップロードできる部分だけを抽出できるなら、その範囲で解析します。抽出できない場合は、社内環境での解析や人間によるレビューを残します。マスキング後のデータでも、業務構造や顧客名を推測できる記述が残っていないかを投入前に点検します。
保存期間や削除の証跡を社内の管理台帳へ記録できるなら、試験利用の対象を拡張します。条件を満たせないコードは、費用や解析精度にかかわらず投入対象から外します。企業契約の準備はClaude Fable 5恒久提供新料金プランと従量課金への移行対策と合わせて整理できます。
Mozilla・Cloudflare・日立製作所の活用事例
先行事例は検出能力の参考にし、自社への適用では対象コードと修正工程の違いを評価します。
Mozilla:Firefoxの脆弱性修正
Mozillaの事例からは、検出した問題を製品の修正リリースまで運ぶ工程を学べます。
業種・規模:ブラウザなどのソフトウェア開発を担う組織です。
導入時期:2026年のProject Glasswingを通じたClaude Mythos Previewの評価です。
課題:Firefoxのコードに存在するセキュリティ上の問題を見つけ、修正へつなげることです。
施策:Mythos Previewをセキュリティ評価に用い、開発チームが検出結果の確認と修正を進めました。
成果:MozillaのCTOボビー・ホリー氏は、初期評価で見つかった271件の脆弱性の修正をFirefox 150に含めたとMozillaの公式ブログで説明しています。
同じブログでは、以前にClaude Opus 4.6でFirefoxを解析した際は、Firefox 148で22件のセキュリティ関連バグを修正したとしています。271件の内訳は、Mozillaの技術解説でsec-highが180件、sec-moderateが80件、sec-lowが11件と示されています(Mozilla Hacks)。件数の増加を自社に当てはめる際は、比較対象のコード、評価期間、確認・修正の担当範囲をそろえます。大きな検出件数を、そのまま少人数で処理できる件数とは見積もりません。
社内に取り入れるなら、検出からリリースまで同じチケット番号で追跡します。問題の発見、再現、修正、回帰テスト、本番反映を別々の状態に分けると、どの工程で滞留しているかが分かります。修正済みの定義を「コードを書いた時点」ではなく、「対象環境への反映と再検査を終えた時点」にそろえます。
Cloudflare:複数の問題を組み合わせた分析
Cloudflareの活用例は、単独の警告だけでなく、複数の問題のつながりを評価する観点を示します。Cloudflareは自社の50以上のリポジトリにMythos Previewを適用し、低深刻度のバグを連鎖させて深刻な攻撃につなげる能力を確認したと公式ブログで説明しています。範囲を絞った問いを多数のエージェントに割り当て、結果を後から重複排除する構成が網羅性を高めたとしています。Anthropicの初期成果の公表では、Cloudflareは重要経路のシステムで2,000件のバグを見つけ、そのうち400件がHigh/Criticalでした(Project Glasswing初期成果)。
業種・規模:ネットワーク・サイバーセキュリティサービスを提供する企業です。
導入時期:2026年のMythos活用事例です。
課題:一つずつでは影響が小さく見える問題が、組み合わせによって侵入経路になる状況の分析です。
この事例を受けて、自社ではリポジトリ単位の指摘をサービス単位で見直します。例えば認証、ファイル処理、外部通信を別々に確認した後、同じ利用者やデータがそれらを通過する経路を追います。担当が異なるシステムにまたがる場合は、各開発チームが別々に「影響は小さい」と判断する前に、セキュリティ担当者が全体の成立条件を整理します。
分析対象を広げると、コードの持ち出し範囲と関係者も増えます。最初からすべてのリポジトリを接続せず、対象サービスの境界と依存関係を一覧化し、必要な範囲だけ段階的に追加します。
日立製作所:社会インフラ向けソフトウェアでの活用
日立製作所は、2026年6月にProject Glasswingへの参画を発表した、社会インフラ分野の大手企業です。
業種・規模:電機・社会インフラ・ITソリューションを扱う企業です。
導入時期:2026年6月にProject Glasswingへの参画を発表しています。
課題:社会インフラ向けソフトウェアのセキュリティ検証を迅速に進めることです。
日立製作所は2026年7月28日の発表で、日立グループ内の100以上のユースケースにMythosを適用して深刻度の高い潜在的な脆弱性を発見し、数週間かかっていた脅威モデル作成を数時間で実行できることを確認したとしています(日立製作所の発表)。この結果を踏まえ、自社でも検証工程ごとに適用範囲を決めます。
自社で工程短縮を測る場合も、「解析時間」と「完了までの経過時間」を分けます。解析が速くても、担当者への割り当て待ちや承認待ちが長ければ、本番のリスクは残ります。試験利用の報告書には、AIの処理時間と、人間の作業・待ち時間を別々に記載します。

セーフガードとCyber Verification Programの利用条件
Claudeのセーフガード解除を検討する場合は、拒否を回避する細工ではなく、正当な目的を明確にした申請と承認範囲内の利用で対応します。
審査対象モデルと申請の位置づけ
Cyber Verification Programは、高度なサイバー機能へのアクセスを申請する経路です。
Anthropicの公式案内では、セキュリティチームはClaude Opus 5.5、Claude Sonnet 5.5、Claude Mythos 5.1などの高度サイバー機能へのアクセスを申請できます。申請できる状態と、特定モデル・特定用途の利用を承認された状態は区別します。申請したという理由だけで、利用者へ制限緩和済みの権限を配布しません。
申請を担う部署は、法人情報、実施責任者、検証対象の所有・許諾関係、利用目的、実行環境、成果物の保管先、問題発生時の連絡先を社内で整理します。これは公表された審査項目の完全な再現ではなく、企業が正当な利用範囲を説明するための準備です。対象と責任者を説明できない案件は、申請前に社内の検証計画を作り直します。
特定パートナー向け利用と法的条件
提供者によるセーフガード緩和と、法令上許される行為の範囲は別々に判断します。
カバードモデルの利用承認を受けても、第三者のシステムを自由に試験できる権利は生じません。対象を所有する部署や顧客から、検証するシステム、実施期間、許可する操作、停止条件について書面で合意します。国外の担当者や委託先を参加させる場合は、契約上の利用者条件と輸出管理上の制約も法務担当者が扱います。
日本のAI法の存在を、個別モデルへのアクセス許可や、攻撃的な検証への包括的な許可とは扱いません。契約、対象システムへの権限、実施する行為を分けて判断します。
Fable 5の拒否応答とフォールバックの区別
APIが拒否を返した場合は、モデルが切り替わったと推測せず、実際のレスポンスに基づいて処理を分岐します。
Fable 5を含む利用経路でstop_reason: "refusal"を受け取った場合、アプリケーションは「解析に成功して問題がなかった状態」と区別して保存します。HTTP通信が成功した場合でも、依頼した作業が完了したとは限りません。利用した経路の仕様に従い、終了理由、返却本文、リクエスト識別子、対象モデルを記録します。
Claude APIのサーバー側フォールバック(ベータ)は、リクエストで「fallbacks」を指定した場合だけ動作し、拒否の種類に応じてClaude Opus 4.8などの推奨モデルで再実行されます。切り替わった場合は応答の「model」フィールドと「fallback」ブロックに記録されるため、拒否応答だけから自動切替や推論能力の低下を推測しないようにします(拒否とフォールバックの仕様)。自社システムが代替モデルへ切り替える場合は、その切替をアプリケーション側の処理として明記します。ログにも「提供者からの拒否」と「自社のモデル切替」を別のイベントとして残します。
正当な解析依頼へのプロンプト調整
正当な防御目的の依頼が拒否された場合は、権限・対象・成果物を明記して依頼範囲を狭めます。
目的を偽る、役割を装う、命令を隠すといった方法では対応しません。実行可能な攻撃コードの生成が不要なら、原因の説明、修正案、回帰テストの作成に依頼を分けます。再送を繰り返して制限をすり抜けるのではなく、処理を止めて担当者に引き継ぐ上限を設けます。
当社が所有するリポジトリのコードレビューです。対象は指定したコミットの認可処理に限定します。権限のない利用者が他の利用者の情報へアクセスし得る箇所を説明し、修正案と回帰テスト案を提示します。外部システムへの接続、認証情報の取得、攻撃の実行は行いません。
このように整理しても拒否される場合は、既存の静的解析や人間によるレビューへ戻します。高度な検証が業務上必要なら、責任者が承認済みの利用経路を検討します。拒否を「異常」として無制限にリトライする設計は避けます。
隔離環境での検証範囲
検証コードを動かす場合は、本番や第三者の環境へ到達しない構成を先に作ります。
機密情報を除いた検証用データと短命の認証情報を使い、外向き通信、接続先、実行時間、CPU・メモリを制限します。AIに実行権限を与える場合も、許可したツールと対象だけを操作できるようにします。異常な通信や処理負荷を検知したら、モデルの応答を待たずに実行基盤側で停止します。
実行対象と停止手段を制御できるなら、承認した範囲の再現試験へ進みます。制御できない場合は、コードを実行せず、静的なレビューと修正案の検討にとどめます。検証後は一時環境、認証情報、生成した攻撃関連の成果物を台帳に沿って削除します。
導入時の注意点と失敗パターン
導入前に、誤検出の受付、修正待ちの管理、権限分離、停止時の代替処理を用意すると、検出件数が増えても業務を止めずに対応できます。
未整理の検出結果を開発現場へ渡す失敗
AIの出力をそのまま開発チームへ渡すと、重複や再現しない指摘の調査に時間を使います。
セキュリティ担当者は、指摘ごとに対象コミット、問題箇所、成立条件、想定される影響を整理します。同じ原因から生じた指摘はまとめ、既知の問題と重複するものは既存チケットへひも付けます。再現しない場合も単に削除せず、試した条件と採否の理由を残します。
修正の優先度は、AIが付けた深刻度だけで決めません。外部公開、到達可能性、必要な権限、扱うデータ、悪用の兆候、回避策の有無を合わせます。外部から到達でき、認証なしで機密情報へ影響する問題は先に隔離や機能制限を行い、その後に恒久修正へ進みます。影響を限定できる問題は、開発チームと期限を合意して計画修正へ回します。
検出数だけを成果にする失敗
検出件数を増やすだけでは、未修正の問題が積み上がる状況を見落とします。
修復ボトルネックとは、発見した問題を評価・修正・展開する処理が追いつかず、リスクが残り続ける状態です。スキャン対象を増やす前に、週ごとの受付件数と完了件数を比較します。未処理が増え続ける場合は、対象を絞り、修正担当者の確保や重複整理を先に進めます。
運用指標 | 測定方法 | 悪化した場合の対応 |
|---|---|---|
初回トリアージまでの時間 | 受付から担当者が採否を判断するまで | 受付窓口を一本化し、担当不明のチケットを解消します。 |
再現・確認できた指摘の割合 | 確認できた件数を審査済み件数で割ります。 | 入力範囲や指示を見直し、不要な警告を減らします。 |
修正待ち件数 | 対応決定済みで本番未反映の件数 | 期限、担当、暫定対策を付けて滞留を処理します。 |
本番反映までの時間 | 受付から展開・再検査完了まで | レビュー待ちとリリース待ちを分けて改善します。 |
差し戻し・回帰不具合 | 修正後に再作業が生じた件数と原因 | 回帰テストと変更範囲の指定を見直します。 |
例えば、試験利用中に受付が増えても修正完了が増えないなら、スキャン性能の評価だけで本番展開を決めません。どの工程に待ち時間があるかを測り、担当変更、対象縮小、外部支援の利用を選びます。数値目標は自社の試験結果から設定し、他社の件数をそのまま目標にしないようにします。
パッチの自動適用を急ぐ失敗
脆弱性の説明が正しくても、提案された修正が業務仕様を壊す場合があります。
認可処理を厳しくした結果、正規の利用者まで操作できなくなるケースを想定します。入力検証の追加では、既存の連携先が使う値を拒否しないかを調べます。修正レビューでは、問題が再発しないテストに加えて、正常な操作を維持するテストも実行します。
本番変更に時間がかかる場合は、アクセス制限、対象機能の停止、監視強化などの暫定対策を先に選びます。暫定対策には解除条件と期限を付け、恒久修正のチケットを残します。AIが安全と判定したという理由で、変更管理の承認やロールバック準備を省略しません。
サービス停止時に同じ処理を別モデルへ流す失敗
マルチモデル構成では、切替先の能力とデータ条件を満たす処理だけを移します。
Microsoft Azure経由のOpenAIモデルや、社内に構築するLlamaなどを代替候補にしても、Mythosと同等の検証能力があるとは扱いません。停止時は、報告書の要約やチケット整理など、代替環境で品質を確認済みの作業から引き継ぎます。高度な解析を引き継げない場合は、処理を停止して既存のセキュリティツールや人間のレビューに戻します。
切替先へソースコードを送れる契約があるかも、事前に判断します。機密コードの送信条件を満たさないモデルへ、障害時だけ自動転送する構成は作りません。モデルの切替を伴う場合は、処理済みの範囲、保留中のチケット、再実行による重複を管理します。
停止・失敗の種類 | 初動 | 代替処理 |
|---|---|---|
通信障害や一時的なエラー | 再試行回数を制限し、処理をキューに保存します。 | 待機可能な処理は復旧後に再開します。 |
安全上の拒否 | 拒否として記録し、自動再送を止めます。 | 依頼範囲を整理するか、人間のレビューへ移します。 |
権限・契約・輸出管理上の停止 | 利用を止め、契約窓口と責任者へ連絡します。 | 利用許諾済みの別工程で業務を継続します。 |
生成した修正の品質不良 | マージを停止し、影響した差分を隔離します。 | 手動修正と既存テストで対応します。 |
監査証跡の不足による調査停滞
問題発生後に処理を追えるよう、入力から本番反映までの識別子をつなぎます。
保存対象は、リクエスト識別子、モデル名、対象コミット、利用したツール、出力、採否、承認者、展開結果です。ただしログにコード全文や認証情報を無制限に残すと、監査基盤から情報が漏れる危険が増えます。詳細データへのアクセス権を絞り、ログには参照用の識別子を残す方法も使います。
社内のログ収集基盤へ自動連携できるなら、実行記録を定期収集します。取得できない項目がある場合は、試験利用中に手動保存で工程を追えるかを試します。責任者や対象コミットを特定できない状態なら、自動パッチ適用には進みません。
社内で共有する利用規程は、【2026】Claude(クロード)とは?読み方・料金と企業活用も参照しながら、開発者と情シスが同じ手順を使える形に整えます。
Claude Mythosに関するよくある質問
利用経路と権限を分けると、Mythosについての問い合わせに同じ基準で回答できます。
Q. Amazon BedrockでClaude Mythosは利用可能ですか
A. Amazon BedrockにはClaude Mythos 5.1(モデルID「anthropic.claude-mythos-5-1」)のモデルカードがあり、プレビュー(ベータサービス)として、Anthropicの信頼済みアクセスプログラムで承認された組織に限って提供されています。東京・大阪リージョンからはGlobalクロスリージョン推論でのみ呼び出せ、利用にはプロバイダーへのデータ共有の設定が必要です(Amazon Bedrockのモデルカード)。対象のモデルID・リージョン・契約上の利用資格がそろえばBedrock経由の検証に進み、そろわなければその経路を前提とした設計は保留します。
Q. 一般のClaude CodeでMythosモデルを選択できますか
A. Claude SecurityのスキャンでMythosの能力を使うことと、一般のClaude CodeでMythos本体を選択することは別です。Anthropicは、Mythosによるスキャンが他の製品でのMythos利用には広がらず、Claude Codeでの修正には組織が利用できるモデルが使われると説明しています。Claude Code向けのClaude Securityプラグインも、Claude Codeのアカウントで利用できるモデルで動作します(Anthropicの発表)。Claude Codeで修正作業を行う権限を、Mythosへの直接アクセス権として扱わないようにします。
Q. セーフガードを完全に解除して利用する方法はありますか
A. 一般利用者が任意の設定で制限を全面解除できるとは扱いません。高度なサイバー機能が必要な場合は、Cyber Verification Programなどの承認された経路で、認められた対象と用途に限って利用します。
Q. Claude Enterpriseの契約だけでMythosを自由に使えますか
A. Enterpriseの契約と、Mythos本体への直接アクセス承認は分けて判断します。Claude Securityの利用では対象リポジトリと成果物の権限を設定し、モデル直接利用が必要なら別の申請として処理します。
Q. Claude Mythos 6も導入候補に含めるべきですか
A. 名称が話題になっているだけでは、提供済みのモデルとして調達計画へ入れません。候補に含める条件は、公式のモデル識別子、提供条件、料金、利用資格をそろえられることです。
限定検証から本番運用までの導入判断
最初の導入では一つのリポジトリを対象に、検出から修正・再検査までを完了させてから対象を広げます。
担当者と完了条件をそろえた試験計画
試験利用の開始前に、解析担当、修正担当、承認者、停止判断者を決めます。
対象に選ぶのは、所有関係と利用許諾が明確で、テストを実行できるコードです。本番への影響がある機能でも、隔離された複製環境で試せるなら検証対象にできます。反対に、秘密情報を除去できない、変更内容をレビューする担当者がいない、復旧手順を用意できない場合は、対象選定からやり直します。
実施段階 | 主担当 | 実施内容 | 次へ進む条件 |
|---|---|---|---|
開始前 | 情シス・法務・開発責任者 | 契約、対象、データ、権限、費用上限を整理します。 | 対象コードを投入でき、責任者と停止手順が決まっています。 |
初回スキャン | セキュリティ担当者 | 対象コミットを固定し、検出結果を分類します。 | 指摘ごとに採否と優先度を説明できます。 |
修正検証 | 開発担当者・レビュー担当者 | 専用ブランチで修正し、回帰テストを実行します。 | 差分、テスト結果、ロールバック手順がそろっています。 |
展開 | 変更承認者・運用担当者 | 段階反映と監視、再検査を行います。 | 問題の解消と業務機能の維持を確認できています。 |
対象拡張 | 情シス・開発責任者 | 処理件数、工数、滞留を評価します。 | 未処理を増やさず、次の対象を担当できる体制があります。 |
本番展開前のチェックリスト
チェック項目が埋まった工程だけを本番化し、未整備の工程は人間の作業として残します。
利用モデル、バージョン、提供経路、契約主体を台帳に記録しています。
Claude Securityの利用とモデル直接アクセスを、別の申請として管理しています。
対象リポジトリとコミット、投入を禁止する情報を特定しています。
スキャン接続と修正接続の権限を分け、不要な書き込み権限を付けていません。
指摘の受付窓口、トリアージ担当、修正担当、承認者が決まっています。
誤検出や対応不要の判断にも、採否の理由を残しています。
拒否、通信失敗、権限エラー、正常完了を別々に記録しています。
パッチのレビュー、回帰テスト、再検査、ロールバックを試しています。
代替モデルへ送信できるデータと、停止する処理を区別しています。
サービス停止を想定した業務継続計画(BCP)に、手動対応の担当者を記載しています。
継続利用と対象拡張の判断基準
試験終了後は、検出精度、修正完了までの工数、残存リスクの3点で継続可否を決めます。
新たな問題を見つけ、担当者が無理なく修正を完了できたなら、同じ手順を使えるリポジトリへ拡張します。指摘は有用でもレビューが滞る場合は、スキャン頻度や対象を絞って継続します。権限やデータ条件を満たさない場合は、その対象での利用を止め、別の解析手段を残します。モデル名や話題性を、対象拡張の理由にしないようにします。
報告書には、利用したモデルと条件、採用した指摘、修正結果、担当工数、費用、残課題を記載します。後継モデルへ切り替える場合も、同じ評価票を使って既存の基準を満たすかを試します。提供体制や監視の論点は、Claude Mythos 5.1公開|情シスが押さえる性能・提供体制・監視リスクと合わせて整理できます。

▲ 限定検証から安全に本番運用・対象拡張へ進めるための導入ステップ。
まとめ
Claude Mythosの導入では、Claude Securityの成果物利用、Claude Codeでの修正、モデル本体への直接アクセスを分けて管理します。情シスは明日、対象リポジトリを一つ選び、修正担当者と承認者、投入できるデータ、停止時の代替手順を決めます。その後、検出から本番反映・再検査までを試し、レビュー時間と未処理件数を測定します。処理できる範囲が分かってから対象を広げ、性能向上を修正完了までつなげます。



本記事の内容に誤り等がございましたら、こちらからご連絡ください。
監修
Admina Team
情シス業務に関するお役立ち情報をマネーフォワード Adminaが提供します。
SaaS・アカウント・デバイスの管理を自動化し、IT資産の可視化とセキュリティ統制を実現。
従業員の入退社対応や棚卸し作業の工数を削減し、情報システム部門の運用負荷を大幅に軽減します。
中小企業から大企業まで、情シス・管理部門・経営層のすべてに頼れるIT管理プラットフォームです。